بر خلاف هرآنچه تا کنون میدانستیم
شاید جنجالیترین ادعای دنیای هوش مصنوعی تاکنون: هوش مصنوعی جعبه سیاه نیست
سید محمدجواد فیاض
- ۲۹ مهر ۱۴۰۵
یادداشتی جنجالی از سوی یکی از پژوهشگران برجسته نشان میدهد که هوش مصنوعی ممکن است در واقع قابلپیشبینیتر از چیزی باشد که تصور میکردیم. در چند روز گذشته، دنیای هوش مصنوعی درگیر یک مقاله ۲۶ هزارکلمهای از «نیک کاماراتا» (Nick Cammarata)، پژوهشگر هوش مصنوعی بوده است. مقاله Neural Networks Are Already Clean «مهمترین مقاله»، «مهمترین دستاورد» و «بهترین خبر سال» توصیف شده است؛ برخی حتی آن را مهمترین دستاورد در تاریخ پژوهش هوش مصنوعی یا شاید در تمام دوران دانستهاند. سم آلتمن، مدیرعامل OpenAI نیز از آن تمجید کرده است.
شبکههای عصبی مصنوعی از همان ابتدا هم قابلفهمتر از آن چیزی بودهاند که تصور میکردیم.
کاماراتا مجموعهای از ادعاهای جسورانه و تقریباً شگفتآور درباره ماهیت هوش مصنوعی مطرح میکند؛ ادعاهایی که اگر درست باشند، برخی از فرضهای بنیادین صنعت او درباره همان فناوریای را زیرورو خواهند کرد که در حال ساخت آن است. پس از ماهها فعالیتهای گسترده برای هککردن سیستمهای هوش مصنوعی و افزایش اعتراضهای عمومی به این صنعت، بسیاری از افراد دیدگاههای کاماراتا را روزنهای از امید میدانند؛ امیدی نهفقط به درک بهتر این فناوری، بلکه به امکان کنترل آن، در شرایطی که هوش مصنوعی با سرعت در حال گسترش در جهان است. خود کاماراتا میگوید فکر میکنم خبرهای خوبی راجعبه ماهیت شبکههای عصبی مصنوعی دارم.
در یک کلام
شبکههای عصبی مصنوعی از همان ابتدا هم قابلفهمتر از آن چیزی بودهاند که تصور میکردیم.
اگر بخواهیم حرف اصلی کاماراتا در Neural Networks Are Already Clean را خلاصه کنیم، او معتقد است مدلهای هوش مصنوعی مولد برخلاف تصور رایج، در واقع جعبه سیاه نیستند. این تصور رایج بر این فرض استوار است که سیستمهای یادشده چنان بزرگ و پیچیدهاند که درک سازوکار درونی آنها تقریباً ناممکن است. اما کاماراتا استدلال میکند که در حقیقت، مسیری نسبتاً روشن برای فهم این مدلها وجود دارد. اگر این ادعا درست باشد، اهمیت عملی آن میتواند بسیار زیاد باشد. چنین رویکردی راهی برای ترسیم نقشه سازوکارهای درونی مدلهای هوش مصنوعی فراهم میکند و در نتیجه، شاید بتوان از بروز انواع آسیبها جلوگیری کرد.
اهمیت این استدلال بهاندازه اهمیت فردی است که آن را مطرح میکند. کاماراتا که پیشتر در OpenAI کار میکرد، چهرهای معتبر در حوزه تخصصی خود به شمار میرود. او سالها پیش نقشی کلیدی در شکلگیری دیدگاهی ایفا کرد که درست نقطه مقابل ادعای کنونی او بود، دیدگاهی که امروز به باوری رایج تبدیل شده است؛ همان دیدگاهی که میگوید شبکههای عصبی، یعنی معماری نرمافزاری زیربنای هوش مصنوعی مولد، قابلدرک نیستند یا دستکم درک آنها بسیار دشوار است. کاماراتا که اکنون در شرکت پژوهشی هوش مصنوعی گودفایر (Goodfire) فعالیت میکند، در مقاله جدید خود عملاً میگوید که از آن زمان تاکنون، او و تمام حوزه پژوهشیاش در اشتباه بودهاند.
شاید درک اشتباه
برای بیش از یک دهه، جامعه پژوهشی هوش مصنوعی تحت سلطه یک فرضیه بنیادین قرار داشت:
شبکههای عصبی عمیق، موجوداتی غیرقابلفهم، درهمتنیده و مملو از ترکیبات تصادفی هستند.
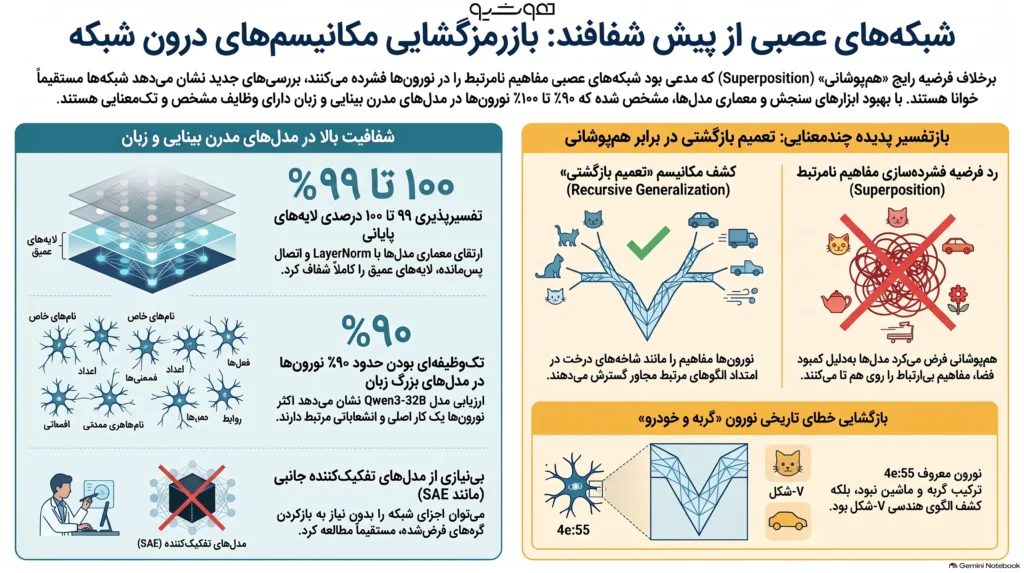
طبق این دیدگاه سنتی، نورونهای شبکه هنگام مواجهه با کمبود ظرفیت، مفاهیم کاملاً بیربط را به دلیل عدم تداخل در ابعاد بالا روی هم تا میکنند؛ پدیدهای که تحت عنوان «برهمنهی» یا «سوپرپوزیشن» (Superposition) شناخته شد. بر پایه این باور، جامعه علمی به این نتیجه رسیده بود که بررسی مستقیم نورونها و مدارهای خود شبکه عصبی بیفایده است و باید ابتدا با ابزارهای بازسازی مانند «خودرمزگذارهای تنک» (Sparse Autoencoders – SAEs) این گرههای کور باز شوند تا مدل قابلمطالعه شود.
اما کاماراتا در مقاله Neural Networks Are Already Clean فرضیهای پژوهشی درباره قابلیت تفسیرپذیری شبکههای عصبی مطرح میکند:
شاید یکی از موانع اصلی درک سازوکار درونی مدلهای هوش مصنوعی، نه پیچیدگی ذاتی آنها، بلکه برداشت نادرست از شواهد اولیه، محدودیت ابزارهای پژوهشی و روشهای نامناسب تحلیل بوده باشد.
کاماراتا استدلال میکند که بسیاری از نورونهایی که پیشتر چندمعنایی یا درهمتنیده به نظر میرسیدند، در واقع الگوهای معناداری را تشخیص میدهند که با بررسی دقیقتر ورودیها، اتصالات و نقش آنها در شبکه قابلشناسایی است.
مدلهای هوش مصنوعی مولد برخلاف تصور رایج، در واقع جعبه سیاه نیستند.
این دیدگاه پیامد مهمی برای حوزه مطالعات «تفسیرپذیری مکانیکی» (Mechanistic Interpretability) دارد؛ حوزهای که میکوشد بهجای ارزیابی صرف رفتار خروجی مدلها، سازوکارهای داخلی آنها را از طریق مطالعه نورونها، مدارها و جریان اطلاعات در شبکه توضیح دهد. اگر فرضیه کاماراتا درست باشد، برای فهم بسیاری از شبکههای عصبی لازم نیست ابتدا ساختار داخلی آنها را به مجموعهای از ویژگیهای مصنوعی تجزیه کنیم. میتوان خود شبکه را مستقیماً مطالعه کرد و با استفاده از آزمایشهای هدفمند، به توضیحی از عملکرد آن رسید.
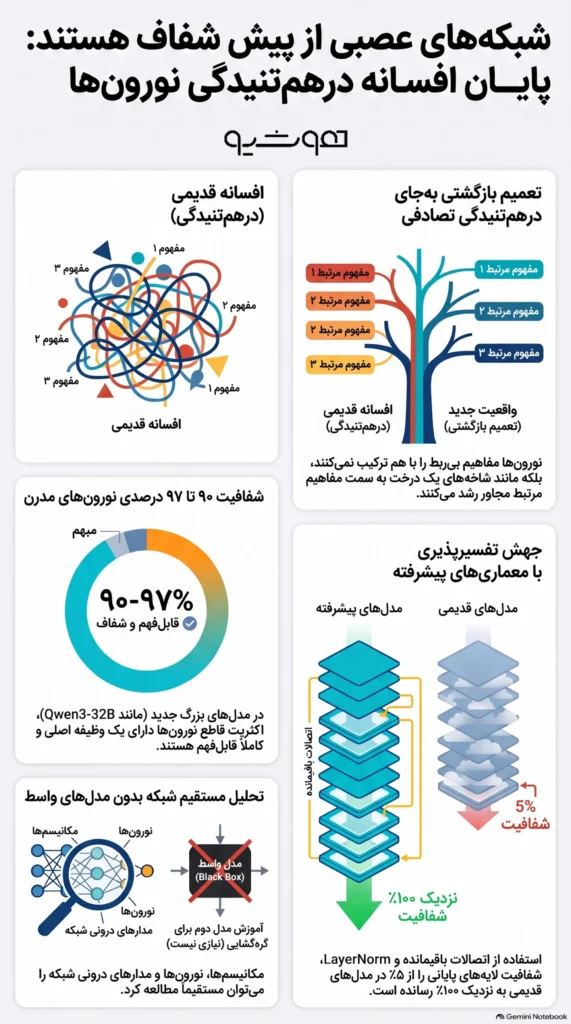
ایده اصلی این پژوهش میگوید که شبکههای عصبی از یک اصل یادگیری واحد به نام «تعمیم بازگشتی» (Recursive Generalization) پیروی میکنند. در این الگو، یادگیری ساختاری فرکتالی دارد و نورونها بهجای بستهبندی تصادفی مفاهیم بیارتباط با هم، شاخههای محلی متناسب با ابعاد معنایی همجوار را میسازند. در نتیجه، اجزا و مدارهای داخلی خود شبکه، واحدهای کاملاً خوانا، ساختارمند و قابلبررسی مستقیم علمی هستند و نیازی به دستکاری یا تجزیه اجباری شبکه نیست.
بااینحال، کاماراتا تأکید میکند که این مقاله یک فرضیه پژوهشی در حال بررسی است، نه اثبات نهایی حلشدن مسئله تفسیرپذیری. او درباره ظرفیت این رویکرد برای مدلهای بسیار بزرگ خوشبین است، اما اذعان دارد که مدلهای زبانی در مقیاس تریلیون پارامتر هنوز به طور کامل فهمیده نشدهاند.
بازنگری در مفهوم نورونهای چندمعنایی و برهمنهی
شبکههای عصبی که با الهام از مغز انسان طراحی شدهاند، از اتصالات لایهلایه میان گرههای منفرد یا همان «نورونها» تشکیل میشوند. این نورونها هنگام پاسخگویی به یک پرسش فعال میشوند و اطلاعات را برای یکدیگر ارسال میکنند. پژوهشهای پیشین از جمله تحقیقات خود کاماراتا، نشان داده بودند که نورونهای منفرد در سامانههای یادگیری ماشین میتوانند در پاسخ به موضوعات متعدد و نامرتبط فعال شوند.
یکی از مفاهیم محوری در پژوهشهای اولیه تفسیرپذیری شبکههای عصبی، «نورون چندمعنایی» (Polysemantic Neuron) بود؛ نورونی که ظاهراً به چند مفهوم نامرتبط پاسخ میدهد یا عملکردش را نمیتوان با یک توضیح منسجم بیان کرد. نمونه مشهور این پدیده در مدل بینایی InceptionV1 مشاهده شد: نورونی که در پاسخ به تصویر چهره گربهها و نمای جلویی خودروها فعال میشد.
توضیح غالب برای این پدیده، فرضیه «برهمنهی» بود. بر اساس این فرضیه، شبکههای عصبی ممکن است با محدودیت تعداد نورونها مواجه شوند و برای نمایش تعداد بیشتری از ویژگیها، مفاهیم نامرتبط را در یک فضای مشترک کدگذاری کنند. در چنین وضعیتی، یک نورون میتواند نماینده چند ویژگی مستقل باشد؛ زیرا این ویژگیها در شرایط خاصی با یکدیگر تداخل نمیکنند.
اگر این فرضیه درست باشد، مطالعه مستقیم نورونها ممکن است گمراهکننده باشد. برای مثال، نمیتوان با مشاهده یک نورون نتیجه گرفت که چه مفهومی را نمایش میدهد؛ زیرا ممکن است چند مفهوم مستقل در آن ترکیب شده باشند. در نتیجه، پژوهشگران به روشهایی مانند «خودرمزگذارهای تنک» روی آوردند تا نمایشهای داخلی شبکه را به مجموعهای از ویژگیهای جداگانهتر تجزیه کنند. اما کاماراتا معتقد است شواهد کلاسیک این فرضیه بهدرستی تفسیر نشدهاند. از نظر او، بسیاری از نورونهایی که نمونهای از برهمنهی تصور میشدند، در واقع الگوهای مشترک یا روابطی را شناسایی میکنند که میان مفاهیم ظاهراً متفاوت وجود دارد.
نمونه گربه و خودرو: نورونی برای شکل V
نورون مشهور 4e:55 در InceptionV1 نمونهای از این بازنگری در مفهوم «نورون چندمعنایی» است. پژوهشگران پیشتر تصور میکردند این نورون همزمان به گربهها و خودروها پاسخ میدهد؛ دو دستهای که ارتباط معنایی آشکاری با یکدیگر ندارند. بررسی دقیقتر کاماراتا نشان داد که ممکن است ویژگی مشترک این تصاویر، نه هویت اشیا، بلکه شکل ظاهری آنها باشد. در تصاویر گربهها، خودروها و برخی حیوانات دیگر، الگوهایی با شکل V دیده میشود؛ مانند زاویه میان اجزای صورت یا خطوط موجود در نمای جلویی خودرو.
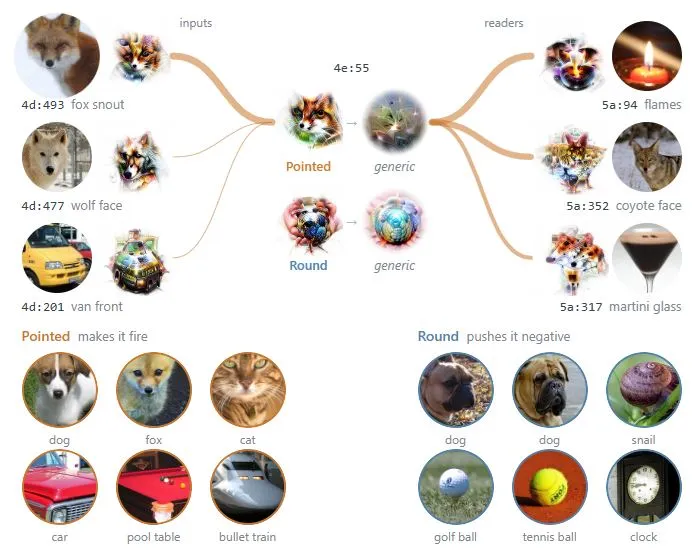
در این تفسیر، نورون مذکور لزوماً مفهوم گربه یا خودرو را تشخیص نمیدهد؛ بلکه به الگویی هندسی پاسخ میدهد که در تصاویر هر دو گروه وجود دارد. این الگو میتواند در ادامه پردازش، به نورونهای دیگری منتقل شود که وظیفه تشخیص اشیا یا ویژگیهای خاص آنها را بر عهده دارند. کاماراتا همچنین به محدودیت ابزارهای تصویری اشاره میکند. روش «مصورسازی ویژگی» (Feature Visualization) برای نشاندادن محرکهای یک نورون، تصاویری مصنوعی تولید میکند که بیشترین فعالسازی را در آن نورون ایجاد کنند. اما فرایند بهینهسازی ممکن است بهجای نمایش دقیق ویژگی موردنظر، به راهحلی برسد که صرفاً هدف عددی را بهخوبی برآورده میکند.
در مثال خودرو و سگ، همین محدودیت باعث شده بود برخی نورونها بهصورت ترکیبی از این دو دسته به نظر برسند. با بررسی دقیقتر اتصالات و تصاویر طبیعی، مشخص شد که بخشی از این ارتباط به شباهت در حالت قرارگیری اشیا مربوط است. برخی نورونها الگوهای مشترک ژست یا جهتگیری را تشخیص میدهند و الزاماً به یک دسته شیء محدود نیستند.
این یافته تمایز مهمی را مطرح میکند:
پاسخدادن یک نورون به چند نوع شیء لزوماً به معنای ترکیب چند مفهوم نامرتبط نیست. ممکن است آن نورون ویژگی مشترکی را تشخیص دهد که برای شبکه مفید است. به همین دلیل، کاماراتا پیشنهاد میکند نورونها را صرفاً بر اساس نام اشیایی که به آنها پاسخ میدهند توصیف نکنیم. گاهی بهتر است عملکرد نورون را بر اساس الگو، رابطه یا تمایزی توضیح دهیم که در پردازش اطلاعات ایجاد میکند.
تعمیم بازگشتی: توضیح جایگزین برای چندمعنایی
تحلیل کاماراتا نشان میدهد که بهجای وجود دو اصل یادگیری متضاد؛ یعنی تعمیم برای مفاهیم مرتبط و سوپرپوزیشن برای مفاهیم بیربط، تنها یک اصل در شبکههای عصبی حاکم است: تعمیم. اما این تعمیم، شخصیتی فرکتالی دارد که پژوهشگران آن را «تعمیم بازگشتی» (Recursive Generalization) نامیدهاند.
بر اساس ایده تعمیم بازگشتی، نورونها هنگام یادگیری میتوانند از یک مفهوم اولیه شروع کنند و بهتدریج شاخههایی از مفاهیم مرتبط را نیز پوشش دهند. این فرایند شبیه رشد شاخههای یک درخت است که در طی آن یک الگوی اولیه گسترش مییابد و موارد مرتبطتری را در برمیگیرد، بدون آنکه لزوماً چند مفهوم مستقل و نامرتبط در آن ذخیره شده باشند.
کاماراتا نمونهای زبانی مطرح میکند. نورونی که ابتدا به قطعهای از رشته حروف «iy» پاسخ میدهد، ممکن است در ادامه به «diy» و سپس عبارت «do it yourself» نیز پاسخ دهد. عبارت نهایی الزاماً همان رشته حروف اولیه را در بر ندارد، اما از نظر ارتباط زبانی یا معنایی میتواند به مسیر یادگیری قبلی متصل شود. در چنین شرایطی، نورون از وظیفه اولیه خود فاصله گرفته است، اما این فاصله به معنای تصادفیبودن عملکرد آن نیست. مسیر گسترش نورون از ارتباطات موجود آغاز شده و به قلمروهای نزدیک یا قابلدسترسی رسیده است.
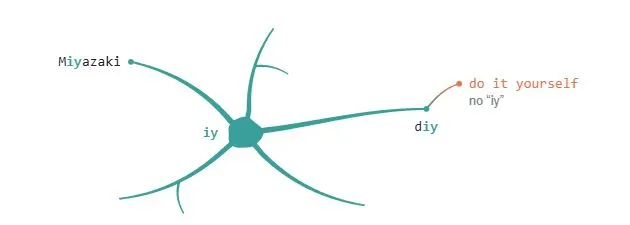
تعمیم بازگشتی تفاوتی اساسی با برهمنهی دارد. در برهمنهی، فرض بر این است که دو ویژگی نامرتبط صرفاً به دلیل محدودیت ظرفیت در یک نورون قرار گرفتهاند. در تعمیم بازگشتی، ویژگیهای متعدد به دلیل ارتباط میان آنها یا مسیر یادگیری مشترک در کنار یکدیگر قرار میگیرند. اگر نورون دو مفهوم مرتبط را پوشش دهد، بررسی این ارتباط میتواند اطلاعاتی درباره نحوه سازماندهی دانش در شبکه فراهم کند. اما اگر دو مفهوم کاملاً نامرتبط صرفاً در یک نورون ترکیب شده باشند، مشاهده این همجواری بهتنهایی اطلاعات چندانی درباره منطق شبکه ارائه نمیدهد.
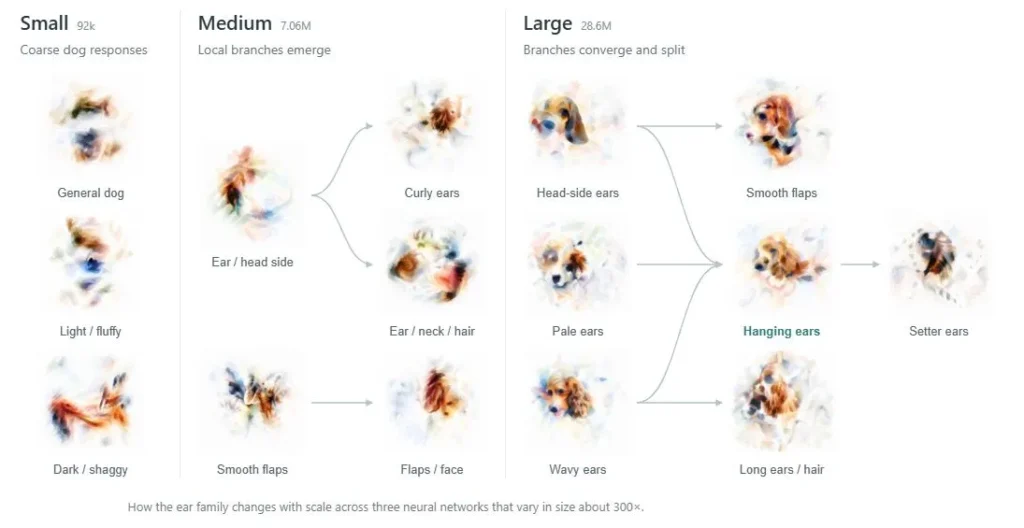
کاماراتا همچنین تأکید میکند که تعمیم بازگشتی میتواند ساختاری سلسلهمراتبی داشته باشد. شبکه ابتدا یک الگوی عمومی را میآموزد و سپس، با افزایش ظرفیت و پیچیدگی، آن را به تمایزهای دقیقتر تقسیم میکند. بهعنوانمثال در مدلهای بینایی یک نورون ممکن است ابتدا به انواع مختلف خودرو پاسخ دهد و سپس در شبکهای بزرگتر، نورونهای تخصصیتری برای مدلها یا ویژگیهای خاص خودرو شکل بگیرند.
این دیدگاه نشان میدهد که افزایش ظرفیت مدل لزوماً به معنای کاهش قابلیت تفسیرپذیری نیست. شبکه بزرگتر ممکن است بتواند مفاهیم را با جزئیات بیشتری از یکدیگر جدا کند، درحالیکه ساختار کلی آن همچنان قابلفهم باقی میماند.
معماری شبکه و محدودیت ابزارهای پژوهشی
یکی از مهمترین استدلالهای کاماراتا در مقاله Neural Networks Are Already Clean این است که دشواری تفسیر شبکههای عصبی همیشه از ماهیت یادگیری آنها ناشی نمیشود. گاهی معماری شبکه یا کیفیت ابزارهای پژوهشی، درک سازوکارهای داخلی را دشوار میکند. کاماراتا برای توضیح این مسئله به InceptionV1 اشاره میکند. در پژوهشهای اولیه، لایههای پایانی این مدل تقریباً غیرقابلتفسیر به نظر میرسیدند. این وضعیت بهعنوان شاهدی برای این دیدگاه تلقی میشد که شبکههای عصبی در لایههای عمیق، ویژگیهای نامرتبط را در هم میآمیزند.
اما کاماراتا معتقد است که با استفاده از معماریهای جدیدتر، میتوان به نتایج بسیار متفاوتی رسید. در آزمایشهای او، شبکههای کانولوشنی مدرن با تعداد پارامترها و دادههای آموزشی قابلمقایسه، نورونهای قابلتفسیرتری داشتند. اتصالات باقیمانده (Residual Connections)، نرمالسازی لایهای (Layer Normalization) و برخی بهبودهای معماری، به یادگیری بهتر لایههای عمیق کمک میکنند و همزمان میتوانند سازمانیافتگی مفهومی آنها را افزایش دهند.
کاماراتا مدعی است که در یک مدل بینایی آموزشدیده با این بهبودها، حدود ۹۹ تا ۱۰۰ درصد نورونهای لایه پایانی بهسادگی قابلتفسیر بودهاند. او همچنین نسخههایی از این مدل را در اندازههای متفاوت آموزش داده و گزارش میکند که ساختار کلی آنها در بازهای با اختلاف اندازه حدود ۳۰۰ برابر، همچنان قابلفهم باقی مانده است.
این نتیجه به معنای آن نیست که همه نورونها دقیقاً یک مفهوم ساده را تشخیص میدهند. مقصود این است که میتوان برای عملکرد آنها توضیحی منسجم پیدا کرد و ارتباطشان با دیگر بخشهای شبکه را بررسی کرد. ابزارهای پژوهشی نیز در این تغییر نقش داشتهاند. بهبود روشهای مصورسازی ویژگی، تنظیمات بهینهسازی و شیوههای بررسی اتصالات نورونی باعث شدهاند برخی نورونهایی که قبلاً آشفته به نظر میرسیدند، الگوهای مشخصتری نشان دهند.
در نتیجه، بخشی از آنچه به شبکه نسبت داده میشد، ممکن است ناشی از ابزار مشاهده بوده باشد. اگر روش مصورسازی بهدرستی تنظیم نشده باشد، پژوهشگر ممکن است خروجی آن را بهاشتباه نشانهای از پیچیدگی یا درهمتنیدگی ذاتی مدل بداند. از دیدگاه کاماراتا، این مسئله در تاریخ تفسیرپذیری بارها تکرار شده است. گاهی پیشرفت در فهم شبکه نه با طراحی روشهای پیچیدهتر برای تجزیه آن، بلکه با اصلاح ابزارهایی حاصل میشود که شبکه را از طریق آنها مشاهده میکنیم.
آیا خودرمزگذارهای پراکنده ویژگیهای پنهان را آشکار میکنند؟
«خودرمزگذارهای پراکنده» یا SAEها یکی از ابزارهای مهم پژوهش در تفسیرپذیری مدلهای زبانی و بینایی هستند. این روشها تلاش میکنند فعالسازیهای شبکه را به مجموعهای از ویژگیهای قابلتفکیک تبدیل کنند تا مطالعه مفاهیم درونی مدل آسانتر شود.
فرض اصلی این است که اگر چند ویژگی در یک نورون با یکدیگر ترکیب شده باشند، ممکن است یک مدل تجزیهکننده بتواند آنها را جدا کند و ساختار پنهان شبکه را آشکار سازد. کاماراتا این فرض را در شبکههای بینایی بررسی میکند. او خودرمزگذارهای پراکندهای را روی لایههای مختلف آموزش میدهد و ویژگیهای حاصل را با نورونهای اصلی مقایسه میکند.
بر اساس گزارش او، بیشتر ویژگیهای کشفشده توسط این مدلها معادل یا نسخهای نزدیک به نورونهای موجود هستند. برای نمونه، در لایه پایانی یکی از مدلها، حدود ۸۸ درصد فعالیت خودرمزگذار به ویژگیهایی مربوط بوده که تقریباً بازتولید یک نورون منفرد بودهاند. ویژگیهای باقیمانده نیز عمدتاً گروهبندیهایی از نورونهای موجود را نشان میدادند. در این آزمایشها، خودرمزگذارها ویژگی بنیادیای را آشکار نکردند که نورونهای اصلی بهتنهایی قادر به نمایش آن نباشند.
البته او کاربرد این ابزارها را رد نمیکند. خودرمزگذارها میتوانند برای شناسایی سریع محتوای یک تصویر یا ساختن دستهبندیهای سطح بالاتر مفید باشند. میزان سودمندی آنها نیز ممکن است با اندازه مدل تغییر کند. در مدلهای کوچکتر که نورونهای عمومیتری دارند، این ابزارها میتوانند کمک بیشتری ارائه دهند.
اما از نظر وی باید میان دو هدف یعنی ساخت فهرستی از ویژگیهای قابلشناسایی و درک سازوکار واقعی شبکه تمایز قائل شد. ممکن است روشی در تولید فهرستی منظم از ویژگیها موفق باشد، اما در توضیح اینکه مدل چگونه تصمیم میگیرد، مزیت بنیادی نداشته باشد. در رویکرد پیشنهادی کاماراتا، نورونها و مدارهای اصلی باید نقطه شروع پژوهش باقی بمانند. تجزیههای ثانویه میتوانند در کنار آنها استفاده شوند، اما نباید بدون شواهد کافی جایگزین مطالعه سازوکار اصلی شبکه شوند.
شواهدی از مدلهای زبانی بزرگ
کاماراتا استدلال خود را به شبکههای بینایی محدود نمیکند. او درباره مدلهای زبانی جدید نیز گزارشهایی ارائه میدهد که به باورش با فرضیه تعمیم بازگشتی سازگارند. در بررسیهای اولیه مدل Qwen3-32B، کاماراتا تخمین میزند که حدود ۹۰ درصد نورونها یک وظیفه اصلی دارند، حدود ۷ درصد دو وظیفه مرتبط را پوشش میدهند و تقریباً ۲ تا ۴ درصد هنوز بهخوبی فهمیده نشدهاند. این اعداد به معیارهای انتخابشده برای تعریف یک مفهوم، شدت فعالسازی و نحوه ارزیابی نورون وابستهاند و نباید بهعنوان اندازهگیری قطعی تفسیر شوند.
در مجموعهای دیگر از بررسیها، کاماراتا میگوید که بیشتر نورونها را میتوان با یک وظیفه اصلی و شاخههایی مرتبط با آن توضیح داد. او همچنین گزارش میکند که در نمونههای بررسیشده، نورونی با تعداد زیادی وظیفه کاملاً نامرتبط مشاهده نکرده است.
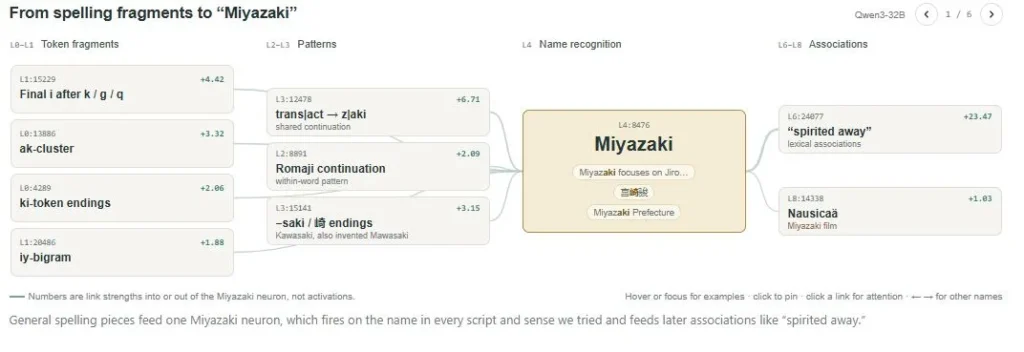
یکی از نمونههای مقاله، چگونگی تشخیص نام «Miyazaki» در یک مدل زبانی بزرگ است. بر اساس نمودار ارائهشده، قطعات عمومی املایی و الگوهای ادامه واژه در لایههای ابتدایی به یک نورون مرتبط با این نام کمک میکنند. سپس این بازنمایی با ارتباطات واژگانی و مفاهیمی مانند آثار مرتبط با میازاکی پیوند میخورد. این نمونه نشان میدهد که یک مفهوم سطح بالاتر لزوماً از ابتدا در یک نورون مستقل و کاملاً تخصصی ظاهر نمیشود. شبکه میتواند آن را از ترکیب و گسترش الگوهای سادهتر بسازد و در لایههای بعدی به ارتباطات معنایی پیچیدهتر برسد.
کاماراتا همچنین بر اهمیت بررسی هر دو قطب نورون تأکید میکند. یک نورون ممکن است با فعالسازی مثبت به برخی مفاهیم پاسخ دهد و با فعالسازی منفی، نقش مهمی در سرکوب یا کاهش احتمال مفاهیم دیگر داشته باشد. اگر پژوهشگر تنها فعالسازیهای مثبت را بررسی کند، ممکن است عملکرد واقعی نورون را ناقص تشخیص دهد. برای مثال، در یکی از تحلیلهای مدل Qwen، بررسی قطب منفی نورونهایی که با اطلاعات مربوط به بابانوئل ارتباط داشتند، به توضیح تغییر پاسخ مدل کمک کرد. حذف نورونهای مربوط به این قطب باعث شد احتمال پاسخ موردنظر بهشدت کاهش یابد؛ اثری که با حذف نورونهای دارای برچسب مثبت مرتبط با همان مفهوم به طور کامل بازتولید نشد.
این مثال اهمیت بررسی سازوکارها و اتصالات واقعی را نشان میدهد؛ برچسب معنایی یک نورون، بهتنهایی برای توضیح نقش آن در خروجی مدل کافی نیست.
از مطالعه یک نورون تا فهم کل شبکه
یکی از پیامهای اصلی مقاله این است که تفسیرپذیری میتواند با پیشرفت پژوهش آسانتر شود. در آغاز، نورونهای ناشناخته بهسختی تفسیر میشوند؛ زیرا توضیح آنها به اطلاعاتی درباره نورونهای دیگر نیاز دارد که هنوز درک نشدهاند. برای مثال، اگر نورونی در پاسخ به نشانههای ظریف اجتماعی یا عاطفی فعال شود، مشاهده چند نمونه ورودی ممکن است ارتباط مشخصی را آشکار نکند. اما اگر پژوهشگر پیشتر نورونهای مرتبط با احساسات، بافت اجتماعی و ساختار جمله را بررسی کرده باشد، میتواند عملکرد نورون جدید را در زمینهای دقیقتر ارزیابی کند.
در این حالت، توضیح یک نورون به فهم نورونهای دیگر کمک میکند و توضیحهای قبلی نیز محدودیتهای تفسیر جدید را مشخص میکنند. پژوهشگر میتواند فرضیه خود را با بررسی ورودیها، خروجیها، اتصالات بالادستی و پاییندستی و تغییر رفتار مدل در اثر دستکاری نورون آزمایش کند.
کاماراتا این فرایند را به تکمیل یک جدول کلمات متقاطع تشبیه میکند که در ابتدا، هر پاسخ مبهم است؛ اما با پرشدن بخشهای بیشتری از جدول، گزینههای ممکن محدودتر میشوند و حل بخشهای باقیمانده آسانتر میشود.
از این منظر، مطالعه کل شبکه ممکن است در برخی موارد از بررسی جداگانه چند سازوکار خاص مؤثرتر باشد. اگر پژوهشگر تنها بر یک پدیده مانند فریبکاری مدل تمرکز کند، ممکن است اجزای دیگری که در ایجاد آن رفتار نقش دارند را نادیده بگیرد. در مقابل، شناخت گستردهتر شبکه میتواند نشان دهد که آن رفتار از چه مؤلفههای کوچکتری ساخته شده است.
اندازه مدل و سازمانیافتگی مفاهیم
همواره یکی از فرضهای رایج این بوده که هرچه شبکه بزرگتر شود، فهم آن دشوارتر خواهد شد؛ زیرا تعداد نورونها، ویژگیها و ارتباطات افزایش مییابد. اما کاماراتا دیدگاه متفاوتی مطرح میکند. بزرگی شبکه میتواند به سازمانیافتگی بهتر مفاهیم نیز کمک کند. در مدلهای کوچکتر، یک نورون ممکن است مفهوم کلی و گستردهای را پوشش دهد. با افزایش اندازه مدل، شاخههای تخصصیتری شکل میگیرند و روابط میان آنها میتواند ساختار منسجمتری بسازد.
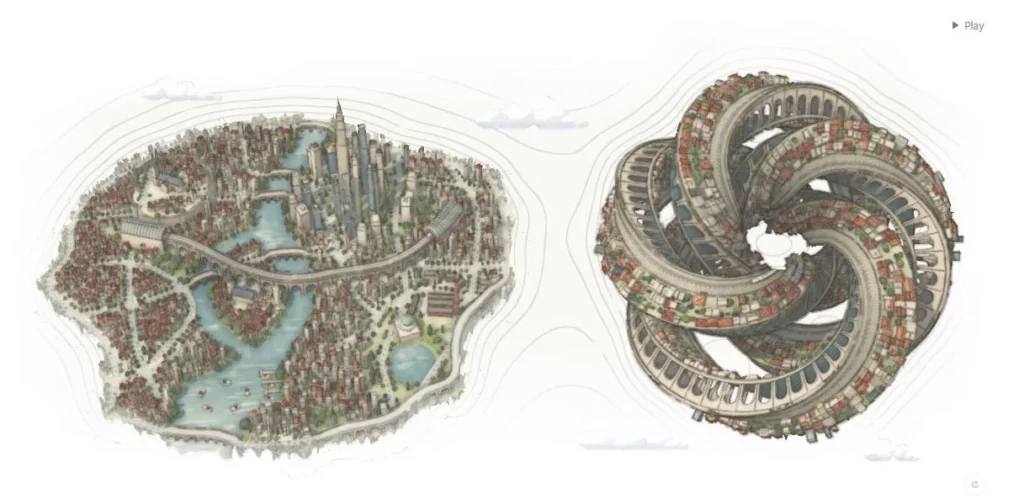
کاماراتا برای توضیح این نکته از مثال شهر استفاده میکند. در یک شهر کوچک، یافتن منطقه مالی ممکن است دشوار باشد؛ زیرا بانکها، شرکتهای بیمه و دفاتر حسابداری پراکندهاند و منطقه تخصصی مشخصی تشکیل ندادهاند. در یک شهر بزرگتر، همین فعالیتها ممکن است در منطقهای قابلشناسایی متمرکز شوند. بنابراین، بزرگی سیستم الزاماً به معنای دشواری بیشتر مسیریابی در آن نیست.
در شبکههای عصبی نیز ممکن است با افزایش ظرفیت، نورونهای تخصصیتر در کنار یکدیگر شکل بگیرند و مسیرهای مرتبط با یک مفهوم را مشخصتر کنند. در چنین شرایطی، داشتن نقشهای از کل شبکه به پژوهشگر کمک میکند تا ارتباط نورونها را در سطحی فراتر از یک نمونه منفرد بررسی کند.
کاماراتا از «انتزاع متصل به ساختار اصلی» (Tethered Abstraction) حمایت میکند؛ رویکردی که امکان مشاهده الگوهای کلی را فراهم میسازد، اما ارتباط آنها با نورونها و مدارهای واقعی را حفظ میکند. در این روش، پژوهشگر میتواند از یک تصمیم مدل شروع کند، مسیرهای مؤثر بر آن را دنبال کند و برای بررسی دقیقتر به نورونها و نمونههای ورودی بازگردد. هدف، ساخت یک نقشه نهایی و کامل نیست، بلکه توسعه مجموعهای از نقشهها و ابزارهای اکتشافی است که بتوانند در سطوح مختلف به درک شبکه کمک کنند.
تعمیم، حافظه و فرضیه سازوکارهای یادگیری
بخش دیگری از مقاله به این پرسش میپردازد که چرا شبکههای عصبی بهجای ترکیب تصادفی مفاهیم، معمولاً ساختارهای قابلفهمتری ایجاد میکنند. کاماراتا فرضیهای را مطرح میکند که بر رقابت میان مسیرهای یادگیری استوار است. هنگام آموزش، مسیرهایی که میتوانند از الگوهای موجود استفاده کنند و خطای پیشبینی را سریعتر کاهش دهند، ممکن است نسبت به مسیرهایی که از ابتدا برای یک مفهوم مستقل ساخته میشوند، مزیت پیدا کنند.
برای مثال، در آموزش یک شبکه با تصویر یک سگ روی چمن، ممکن است مسیرهای متفاوتی برای یادگیری وجود داشته باشد: یک مسیر میتواند جزئیات خاص همان تصویر را حفظ کند و مسیر دیگری ویژگیهای عمومیتر، مانند رنگ سبز چمن یا رنگ خز را تشخیص دهد.
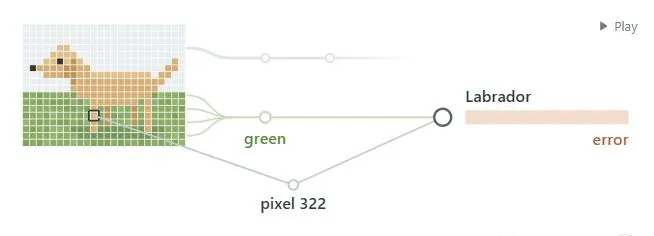
ویژگی عمومیتر ممکن است در بخش بزرگتری از تصویر فعال شود و در نتیجه، سیگنال یادگیری بیشتری دریافت کند. با تکرار این فرایند، مسیر عمومیتر میتواند سریعتر توسعه یابد و برای یادگیری نمونههای بعدی نیز نقطه شروع مناسبی فراهم کند.
این توضیح با فرضیهای که شبکه ابتدا نمونهها را حفظ میکند و سپس در مرحلهای جداگانه تعمیم میدهد، متفاوت است. از نظر کاماراتا تعمیم از همان مراحل ابتدایی آموزش آغاز میشود و مسیرهایی که قابلیت استفاده مجدد دارند، ممکن است زودتر رشد کنند.
کاماراتا این سازوکار فرضی را با مفهوم «بومشناسی مدار» (Circuit Ecology) پیوند میدهد. در این چارچوب، مدارهای شبکه مانند مسیرهایی در حال رقابتاند؛ برخی به دلیل دسترسی به اجزای موجود و قابلیت گسترش، زودتر شکل میگیرند و بخش بیشتری از خطای باقیمانده را جذب میکنند.
او تأکید میکند که این بخش از مقاله هنوز ماهیتی فرضی دارد. سازوکار دقیق این فرایند به بررسی بیشتری نیازمند است و نویسنده آن را توضیح نهایی یادگیری شبکههای عصبی معرفی نمیکند. بااینحال، این فرضیه به یک پیشبینی منتهی میشود. اگر ویژگی نادری در مدل نمایش داده شود، احتمال دارد از مسیرهای مرتبط با مفهوم اصلی خود استفاده کند، نه اینکه الزاماً در ترکیبی تصادفی از ویژگیهای نامرتبط ذخیره شود.
پیامدها برای آینده تفسیرپذیری مکانیکی
بر اساس استدلال کاماراتا، تفسیرپذیری مکانیکی ممکن است بیش از آنچه پیشتر تصور میشد، از بررسی مستقیم شبکههای عصبی سود ببرد. این رویکرد بهجای شروع با فهرستی از ویژگیهای فرضی و تلاش برای استخراج همه آنها، از ساختار موجود شبکه آغاز میکند. پژوهشگران نورونها و مدارها را بررسی میکنند، فرضیههایی درباره عملکردشان میسازند و سپس با آزمایشهای هدفمند، درستی این فرضیهها را میسنجند.
چنین روشی مستلزم ابزارهای بهتر، نقشههای دقیقتر و امکان بررسی شبکه در مقیاس وسیع است. کاماراتا معتقد است عامل انسانی بهتنهایی برای مطالعه شبکههای بسیار بزرگ کافی نیست و استفاده از عاملهای هوش مصنوعی برای بررسی نورونها، ساخت فرضیه و اجرای آزمایشها میتواند این فرایند را گسترش دهد.
بااینحال، مقاله بر ضرورت حفظ ارتباط میان توضیحهای سطح بالا و سازوکارهای واقعی تأکید میکند. یک توصیف معنایی ساده ممکن است برای شروع مفید باشد، اما تا زمانی که نتوان آن را با ورودیها، اتصالات و اثرات واقعی نورون آزمایش کرد، توضیحی کامل محسوب نمیشود.
این موضوع برای پژوهشهای مرتبط با رفتارهای مهم مدل نیز اهمیت دارد. اگر بخواهیم سازوکارهای مرتبط با فریبکاری، پاسخگویی یا سایر رفتارهای پیچیده را بررسی کنیم، ممکن است شناخت چند نورون منتخب کافی نباشد. فهم گستردهتر شبکه میتواند به شناسایی روابطی کمک کند که در بررسی محدود به یک پدیده نادیده میمانند.
محدودیتها و پرسشهای حلنشده
کاماراتا در کنار خوشبینی خود، محدودیتهای مهمی را نیز بیان میکند:
- نخست، پژوهشها هنوز تمام شبکههای عصبی را پوشش ندادهاند. کاماراتا تصریح میکند که همه مدلها به طور کامل بررسی نشدهاند و حتی مشخص نیست چنین کاری از نظر نظری برای تمام مدلها امکانپذیر باشد.
- دوم، ارزیابی اینکه یک نورون دقیقاً چند وظیفه دارد، به تعریف یک مفهوم وابسته است. اگر آستانه فعالسازی تغییر کند یا ارتباطات ضعیفتر نیز در تحلیل لحاظ شوند، تعداد معانی منتسب به نورون ممکن است افزایش یابد. بنابراین، درصدهای ارائهشده در مقاله تخمینهایی وابسته به روشاند، نه معیارهایی قطعی و مستقل از زمینه.
- سوم، برخی سازوکارهای شبکه هنوز بهخوبی فهمیده نشدهاند. کاماراتا به سازوکار توجه (Attention) اشاره میکند و میگوید در این زمینه بهاندازه نورونها پیشرفت نکرده است. او معتقد نیست که دشواری فهم این سازوکارها بهخودیخود شاهدی برای برهمنهی باشد؛ توضیحهای دیگری نیز ممکن است مطرح باشند.
- چهارم، حتی اگر نورونها در بیشتر موارد قابلتفسیر باشند، این مسئله به معنای فهم کامل رفتار مدل نیست. توضیح عملکرد اجزای شبکه، شناخت تعامل میان آنها و پیشبینی رفتار مدل در موقعیتهای جدید، مسائل مرتبط اما متمایزی هستند.
واکنش دنیای هوش مصنوعی
البته همه با کاماراتا موافق نیستند. نخست اینکه، متن ۲۶ هزارکلمهای او صرفاً یک «فرضیه کاری» برای مقالهای فنی بود که قرار است در آینده منتشر شود؛ بنابراین، ارزیابی فنی آن دشوار است. افزون بر این، شبکههایی که کاماراتا با دقت بیشتری بررسی کرده، مدلهای بینایی هستند؛ مدلهایی که عموماً سادهتر از مدلهای زبانی زیربنای ChatGPT و Claude هستند و درک بهتری از آنها وجود دارد. ممکن است کاماراتا اشتباه کرده باشد یا ادعاهای خود را بیش از اندازه بزرگ جلوه داده باشد. پست وبلاگی او داوری همتا (Peer Review) نشده است.
بحثهای شکلگرفته پیرامون مقاله کاماراتا، شکافهای فلسفی موجود در این حوزه را نیز آشکار کردهاند. «نیل ناندا» (Neel Nanda)، مسئول حوزه تفسیرپذیری مکانیکی در گوگل دیپمایند، در ارزیابی یافتههای کاماراتا نوشت: «این پژوهش جالب است، اما فکر نمیکنم تصویر کلی را به طور معناداری تغییر دهد.»
حتی اگر پژوهشگران بتوانند کارکرد هر نورون را در مدلهایی مانند Claude Mythos 5.1 یا GPT-6 Astra تقریب بزنند، این به معنای درک نحوه اتصال نورونها به یکدیگر و چگونگی عملکرد کل شبکه نیست. فیزیکدانان مدلهای مناسبی برای توصیف اتمها و برهمکنشهای میان اتمی در اختیار دارند، اما نمیتوانند صرفاً بر اساس اصول بنیادی، تمام رویدادهای فیزیکی را توضیح دهند یا پیشبینی کنند. به همین دلیل است که پدیدههایی مانند شرایط جوی حدی و غیرقابلپیشبینی یا حتی مفهوم اراده آزاد همچنان محل بحثاند.
مهمتر از همه، شناخت سازوکارهای درونی یک مدل هوش مصنوعی لزوماً به درک چگونگی افزایش قابلیت اطمینان این فناوری منجر نمیشود. تفسیرپذیری ممکن است برای ساخت مدلهای هوش مصنوعی ایمنتر ضروری باشد، اما بههیچوجه بهتنهایی کافی نیست.
اگر مدلهای هوش مصنوعی مولد واقعاً از نظر سازوکارهای درونی قابلفهم باشند، این موضوع بیتردید به ایمنتر شدن فناوری کمک خواهد کرد. بااینحال، بسیاری از افراد در سیلیکونولی، بهویژه کارکنان OpenAI درباره پست وبلاگی کاماراتا با شور و هیجانی وصفناپذیر صحبت میکنند؛ شور و هیجانی که یادآور سابقه طولانی سیلیکونولی در ارائه راهحلهای فنی سادهانگارانه و وعدههای بزرگ است؛ درحالیکه کارنامه این صنعت در عملکردن به وعدههایش چندان یکدست و درخشان نیست.
کلام آخر
پژوهش تاریخی نیک کاماراتا اثبات میکند که شبکههای عصبی نه کلافهای سردرگم و آشفته، بلکه مانند شهرهایی بزرگ، کاملاً سازمانیافته، انتزاعی و منطقی هستند. تشبیه مناسب برای یک شبکه عصبی، نه یک گره کور، بلکه یک جنگل بارانی است که هر موجود در آن علتی زیستی برای حضور خود دارد.
استدلال اصلی مقاله Neural Networks Are Already Clean این است که بخش مهمی از پیچیدگی ظاهری شبکههای عصبی ممکن است از برداشتهای نادرست و ابزارهای ناکافی ناشی شده باشد. کاماراتا معتقد است بسیاری از نورونهایی که چندمعنایی تصور میشدند، در واقع الگوهای مشترک را تشخیص میدهند یا از طریق تعمیم بازگشتی، وظایف مرتبط را گسترش میدهند. این دیدگاه بهجای آنکه بر تجزیه شبکه به مجموعهای از ویژگیهای مصنوعی تکیه کند، مطالعه مستقیم نورونها، مدارها و جریان اطلاعات را در اولویت قرار میدهد.
بااینحال، کاماراتا ادعا نمیکند که همه شبکههای عصبی کاملاً فهمیده شدهاند یا مسئله تفسیرپذیری حل شده است. ادعای محدودتر آن این است که ممکن است برای پیشرفت در این حوزه، نیازی نباشد ابتدا شبکهها را از هم باز کنیم؛ شاید با ابزارهای بهتر، آزمایشهای دقیقتر و بررسی گستردهتر سازوکارهای موجود بتوانیم بخش بزرگی از آنها را مستقیماً درک کنیم.