اضافهکاری یا بازدارنده
چرا واترمارک هوش مصنوعی کارایی لازم را نخواهند داشت
سید محمدجواد فیاض
- ۸ شهریور ۱۴۰۵
شرکتهای فعال در حوزه هوش مصنوعی برای افزایش شفافیت و مقابله با اطلاعات نادرست، واترمارکگذاری خروجی مدلهای خود را آغاز کردهاند؛ اما این رویکرد محدودیتهایی دارد.
با گسترش استفاده از چتباتهای هوش مصنوعی، احتمالاً برای شما هم پیش آمده است که از خود بپرسید آیا متنی که میخوانید را یک انسان نوشته یا یک ماشین. اکنون، در واکنش به قوانین اتحادیه اروپا، بسیاری از شرکتهای هوش مصنوعی در حال افزودن واترمارک به متن، تصاویر و ویدئوهایی هستند که مدلهایشان تولید میکنند؛ با این هدف که بتوانید دقیقاً همین موضوع را تشخیص دهید. امید آن است که این واترمارکها به مهار گسترش اطلاعات نادرست و افزایش شفافیت در استفاده از هوش مصنوعی کمک کنند، اما کارشناسان معتقدند که دستکم در مورد متن، واترمارکگذاری احتمالاً کارایی لازم را نخواهد داشت.
بالاخره بعد از ۲ سال، قانون هوش مصنوعی اروپا با هدف امنیت و شفافیت لازمالاجرا شد
الزام به استفاده از واترمارک بخشی از قانون هوش مصنوعی اتحادیه اروپا (EU AI Act) است که از ۲ اوت لازمالاجرا شده است. OpenAIدر حال حاضر روی تصاویر و فایلهای صوتی خود واترمارکگذاری میکند و اعلام کرده است که قصد دارد در آینده واترمارکگذاری متون را نیز اضافه کند. آنتروپیک نیز اعلام کرده است که مدلهای آیندهاش متنها را واترمارک خواهند کرد. قانون هوش مصنوعی اتحادیه اروپا برای مدلهایی که پیشتر عرضه شدهاند، یک دوره تنفس در نظر گرفته است، اما همه مدلها باید تا ۲ دسامبر امسال قابلیت واترمارکگذاری را ارائه کنند.
«جیمز پادولسی» (James Padolsey) از شرکت NOPE، فعال در حوزه ایمنی هوش مصنوعی میگوید واترمارکهای تصاویر و ویدئوها قابلاعتمادترند، زیرا این محتواها از دادههای متراکم و چندلایه تشکیل شدهاند؛ اما اجرای واترمارک در متن همواره دشوارتر خواهد بود.
یکی از روشهای واترمارکگذاری متن، اعمال الگویی قابلشناسایی از نظر ریاضی بر نحوه انتخاب واژههاست. مدلهای زبانی بزرگ، جملات را با انتخاب واژهای تولید میکنند که از نظر آماری بیشترین احتمال را دارد که در ادامه بیاید. مدلها میتوانند با تغییر نحوه انتخاب این واژهها؛ برای مثال، با انتخاب متناوب محتملترین واژه بعدی و سپس دومین واژه محتمل و تکرار این الگو در سراسر جمله، الگویی را در متن جاسازی کنند، بدون آنکه معنای کلی متن تغییر کند. بر اساس قانون هوش مصنوعی اتحادیه اروپا، شرکتها موظف خواهند بود ابزارهایی ارائه کنند که بتوانند این الگوها را شناسایی کنند و در نتیجه، افراد بتوانند متن تولیدشده توسط هوش مصنوعی را تشخیص دهند.
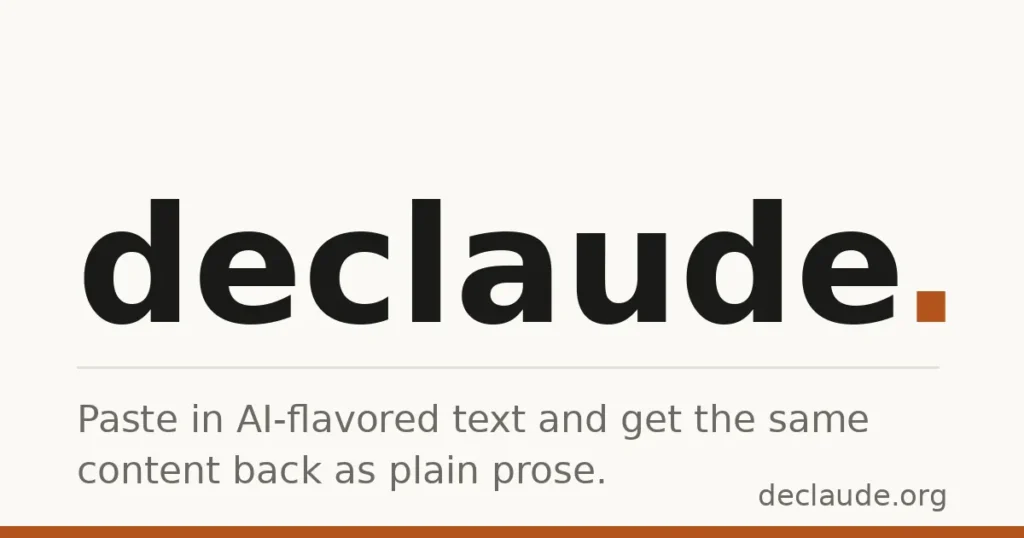
اما پادولسی اشاره میکند که این الگوهای واترمارک حتی در برابر ویرایشهای جزئی نیز آسیبپذیرند و بهراحتی میتوان آنها را حذف کرد. او میگوید: «این روش مفید نیست و نحوهای که مردم قرار است از آن استفاده کنند، نادرست خواهد بود.» پادولسی برای تأکید بر ادعای خود، یک ابزار آنلاین به نام declaude ساخته است که متن تولیدشده توسط هوش مصنوعی را دریافت میکند و با اعمال تغییرات جزئی در آن، کاری میکند که ابزارهای فعلی تشخیص هوش مصنوعی دیگر نتوانند آن را شناسایی کنند. به گفته او، همین فرایند باید روی متنهای دارای واترمارک نیز مؤثر باشد.
پادولسی میگوید حتی بدون وجود چنین ابزارهایی، برخی مدلهای هوش مصنوعی متنباز که از قوانین اتحادیه اروپا تبعیت نمیکنند، همواره در دسترس خواهند بود، زیرا تحت کنترل هیچ شرکت فناوری واحدی نیستند. او میگوید: «هر عامل مخربی بهسادگی از آنها استفاده خواهد کرد و احتمالاً این مدلها ارزانتر و اجرای آنها نیز سادهتر خواهد بود.»
سخنگوی کمیسیون اروپا میگوید: «این قوانین به مردم کمک خواهند کرد تشخیص دهند چه زمانی با یک سیستم هوش مصنوعی در تعامل هستند یا چه زمانی محتوا توسط هوش مصنوعی تولید یا تغییر داده شده است. میزان مقاومت راهکارهای علامتگذاری و تشخیص در برابر حملات خصمانه باید از منظر میزان تابآوری آنها در برابر رفتارهای مخرب ارزیابی شود؛ رفتارهایی مانند حملات مبتنی بر کپیکردن، حذف، بازتولید و تغییر در علامتها.»
درحالیکه نگرانی پادولسی این است که واترمارکها بهراحتی حذف میشوند، برخی دیگر نگران «مثبت کاذب» هستند؛ یعنی مواردی که یک متن بهاشتباه یا صرفاً به این دلیل که یک مدل حتی نقشی جزئی در تولید آن اثر داشته، تولیدشده توسط هوش مصنوعی تشخیص داده میشود.
«پیتر اسکرف» (Peter Scarfe) از دانشگاه ریدینگ در بریتانیا میگوید شرکتهای زیادی محصولاتی را به بخش دانشگاهی او عرضه کردهاند که مدعیاند میتوانند به شناسایی سرقت ادبی دانشجویان کمک کنند؛ هرچند این محصولات از روشهایی غیر از واترمارکگذاری استفاده میکنند. بااینحال، در توضیحات حقوقی یا شرایط استفاده از این محصولات معمولاً تصریح شده است که نباید از این سیستمها برای اثبات قطعی یا مجازات موارد سرقت ادبی استفاده کرد، زیرا هیچکدام کاملاً مصون از خطا نیستند. اسکرف میگوید: «اگر سیستم اعلام کند که ۶۷.۸ درصد احتمال دارد این متن بهنحوی توسط هوش مصنوعی تولید شده باشد، من بهعنوان یک مدرس باید با این نتیجه چهکار کنم؟ واقعاً مطمئن نیستم. این سیستمها کاملاً دقیق عمل نمیکنند و به همین دلیل، کاربرد آنها محدود است.»
ابزارهای تشخیص واترمارک نیز به شیوهای مشابه عمل خواهند کرد و ممکن است متنی را علامتگذاری کنند که صرفاً توسط هوش مصنوعی پردازش شده است، نه متنی که به طور کامل توسط هوش مصنوعی تولید شده باشد. در چنین شرایطی، دانشجویان ممکن است حتی زمانی که فقط از یک مدل خواستهاند اثر دستنویس خودشان را پیش از تحویل، برای بررسی خطاهای دستوری بررسی کند، با دردسر مواجه شوند.
اسکرف میگوید هوش مصنوعی را میتوان برای طیف گستردهای از اهداف به کار گرفت و ذاتاً عامل انتشار اطلاعات نادرست نیست؛ بنابراین شاید اعمال یک سیاست فراگیر برای واترمارکگذاری، ابزاری بیش از حد ساده و غیرظریف برای مواجهه با مسئلهای پیچیده باشد. بااینحال، او اشاره میکند که هوش مصنوعی میتواند مرتکب خطا شود و واقعیتهای جعلی یا بهاصطلاح «توهم» (hallucination) تولید کند و همچنین میتوان از آن برای انتشار سریع دروغها استفاده کرد؛ مانند رباتهای انتشار اطلاعات گمراهکننده در شبکههای اجتماعی.
او میگوید: «ازآنجاییکه این فناوریها با چنین سرعتی وارد شدند و با چنین شتابی توسعه پیدا کردهاند، همه افراد در تمام حوزههای زندگی تا حدی غافلگیر شدهاند و از قافله عقب افتادهاند؛ اما فکر نمیکنم واترمارکگذاری یک گلوله جادویی باشد. فکر نمیکنم ناگهان بتواند مشکلی را که اتحادیه اروپا امیدوار است حل شود، برطرف کند.»
بااینحال، شاید واترمارکها بتوانند بهاندازهای اصطکاک ایجاد کنند که برخی کاربردهای مخرب هوش مصنوعی را کند کنند. «ارمان آیدای» (Erman Ayday) از دانشگاه کیس وسترن ریزرو در کلیولند اوهایو میگوید حتی اگر حذف یک واترمارک به تلاش بسیار ناچیزی نیاز داشته باشد، همین مسئله میتواند در طول زمان، استفاده نادرست از هوش مصنوعی را در برخی زمینهها غیرعملی کند. آیدای میگوید: «هر کسی اگر بهاندازه کافی وقت صرف کند، میتواند در واترمارک دستکاری کند؛ اما وقتی قرار است اینقدر برای آن وقت بگذارید، شاید بهتر بود از همان ابتدا خودتان محتوا را تولید میکردید، درست است؟»
گزارش حاضر در نسخه Augst 2026 نشریه New Scientist منتشر شده است.