گوگل چگونه میزان مصرف Gemini را محاسبه میکند
سیاستهای جدید محدودیت مصرف Gemini: هر پرامپت و محتوا چقدر از سهمیه ۵ ساعته Gemini را مصرف میکند؟
سید محمدجواد فیاض
- ۲۲ مهر ۱۴۰۵
با یک پنجره ۵ ساعته و توان پردازشی بهجای تعداد درخواست؛ گوگل سیاستهای محدودیت مصرف Gemini را تغییر میدهد.
اخیراً گوگل در معماری کنترل مصرف و سیاستهای سهمیهبندی سرویسهای اکوسیستم هوش مصنوعی و رابطهای برنامهنویسی تجاری خود تغییراتی ساختاری اعمال کرده است. این بازنگری با هدف مدیریت بار پردازشی زیرساختهای ابری، بهینهسازی منابع سختافزاری و تفکیک شفافتر سطوح اشتراک پولی و رایگان صورت گرفته است.
گذار از مدل «تعداد درخواست» به «مصرف محاسباتی» (Compute-Based Limits)
تا پیشازاین، اکثر پلتفرمهای تعاملی محدودیتها را بر اساس تعداد ساده پرامپتها در واحد زمان (مانند تعداد پیام در روز) اعمال میکردند. طبق سیاستهای بهروزشده گوگل:
- محاسبه مبتنی بر هزینه پردازش: مصرف کاربر بر پایه منابع سختافزاری موردنیاز پرامپت ارزیابی میشود.
- وزندهی عملیاتها: وظایف ساده متنی مصرف بسیار کمی دارند؛ درحالیکه گفتگوهای طولانی با تاریخچه سنگین، تحلیل اسناد حجیم و پایگاههای کد، تولید تصویر و ویدئو، و فرایندهای استدلال چندمرحلهای (Deep Research) ضریب مصرف سهمیه را با سرعت بالاتری پر میکنند.
مکانیزم وزندهی به درخواستها؛ چرا هزینه هر محتوای متفاوت است؟
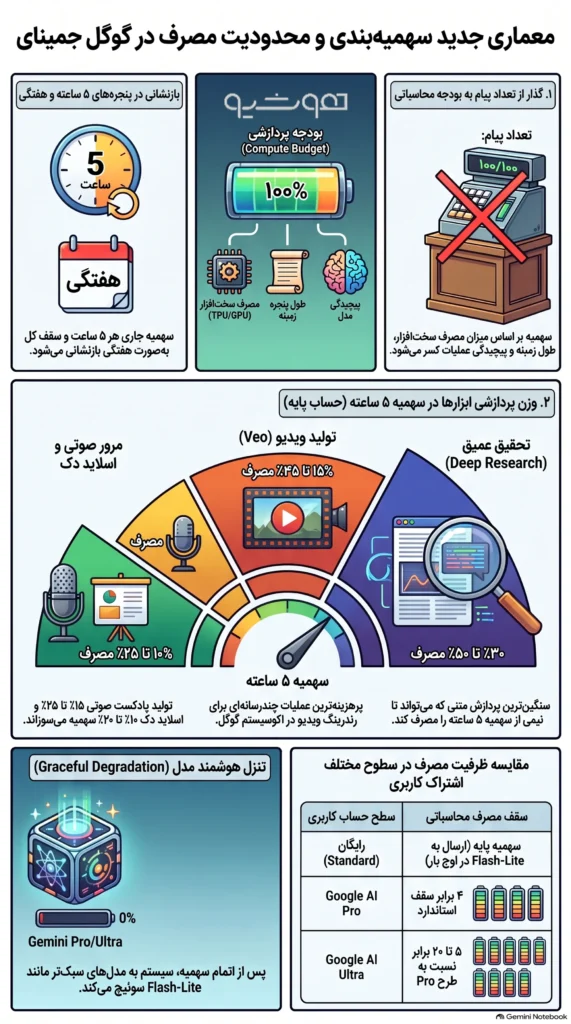
مدل مصرف در اکوسیستم هوش مصنوعی گوگل از حالت شمارش یکپارچه خارج شده و به یک «بودجه بار محاسباتی» (Compute Budget) تبدیل شده است. در این سیستم، هزینه هر درخواست بر اساس مقدار سختافزار (TPU/GPU)، حافظه پنجره زمینه (Context Window)، تعداد مدلهای فعال و رفتوبرگشتهای فرایند استنتاج سنجیده میشود. هر درخواست کسری از سهمیه پنجره ۵ ساعته یا هفتگی کاربر را مصرف میکند.
هنگامی که درخواستی ارسال میشود، گوگل چندین پارامتر را برای محاسبه درصد کسرشده از سهمیه در نظر میگیرد:
- طول و تاریخچه مکالمه: هر بار که در یک چت طولانی پیامی ارسال میشود، مدل کل تاریخچه قبلی را مجدداً بازخوانی و تحلیل میکند؛ بنابراین یک پاسخ کوتاه در انتهای یک گفتگو با ۵۰ پیام، بهمراتب بیشتر از همان پاسخ در یک گفتگوی جدید سهمیه میسوزاند.
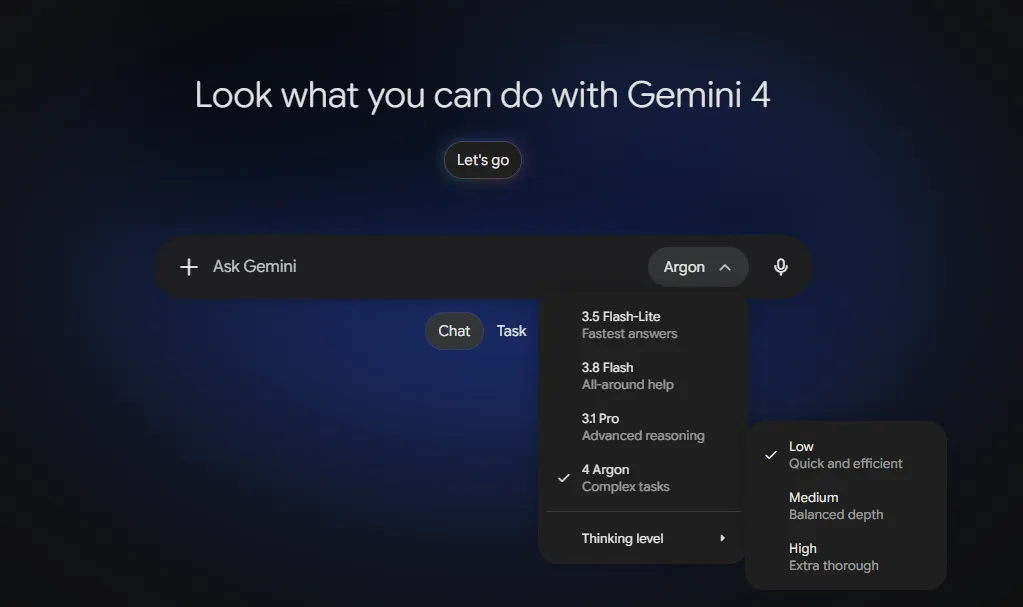
- مدل مورداستفاده: پردازش با مدلهای پایه نظیر Flash-Lite مصرف صفر یا نزدیک به صفر دارد، اما مدلهای پیشرفته (Pro و استدلال عمیق) وزن محاسباتی کاملی به خود میگیرند.
- فرایندهای چندعاملی (Agentic): ابزارهایی که نیاز به جستجوی وب، پیمایش لینکها، ادغام منابع و چند مرحله استدلال پشتسرهم دارند، بالاترین ضربه را به سهمیه ۵ ساعته وارد میکنند.
بررسی قابلیتها و ابزارهای گوگل و تخمین سهمیه مصرفی
میزان مصرف هر عملیات در یک حساب پایه/استاندارد (با ظرفیت پایه قبل از اعمال ضرایب پلنهای پرو) به شکل زیر ارزیابی میشود:
- چتبات Gemini (متن، کد و تحلیل اسناد)
- یک پیام متنی ساده یا ویرایش کوتاه کد: کمتر از ۰٫۵ درصد تا ۱ درصد از سهمیه ۵ ساعته.
- تحلیل فایل یا کتابچه بزرگ (PDF/کد پرحجم): ارسال یک سند ۲۰۰ صفحهای و تحلیل آن به دلیل پر کردن سریع پنجره زمینه، بین ۵ درصد تا ۱۵ درصد سهمیه را کسر میکند.
- قابلیت Deep Research (تحقیق عمیق): این ابزار دهها جستجوی موازی و گزارشگیری چندمرحلهای انجام میدهد؛ اجرای یک پروژه کامل Deep Research میتواند بین ۳۰ درصد تا ۵۰ درصد (و در مواردی تا مرز تخلیه کامل سهمیه ۵ ساعته در اکانتهای رایگان) مصرف به همراه داشته باشد.
- ابزارهای مولد تصویر و ویدئو
- تولید یا ویرایش تصویر: رندرینگ انتزاعی هر تصویر نیازمند پردازش گرافیکی متمرکز است و هر تولید تصویر با کیفیت بالا تقریباً ۲ تا ۵ درصد از بودجه محاسباتی را مصرف میکند.
- تولید ویدئو (Gemini/Flow): تولید ویدئو پرهزینهترین عملیات در اکوسیستم گوگل است؛ بسته به مدت و وضوح کلیپ، تولید یک ویدئوی چندثانیهای میتواند ۱۵ تا ۳۵ درصد از سقف ۵ ساعته را کسر کند (به همین دلیل در حسابهای رایگان بسیار محدود یا غیرفعال است).
- Gemini Notebook
در محیط نوتبوک که اخیراً بخش Studio Generation شاخص تخمین هزینه مصرف (Expected AI Usage) را نیز اضافه کرده است:- اسلاید دک (Slide Deck) یا گزارش تحلیلی: ساخت یک پرزنتیشن کامل بر پایه منابع متعدد، نیازمند خلاصهسازی چندسندی، ساختاربندی محتوا و فرمتبندی بصری است؛ این عملیات حدود ۱۰ تا ۲۰ درصد از سهمیه ۵ ساعته را به خود اختصاص میدهد.
- مرور صوتی و پادکست (Audio Overview): پردازش متن منابع، تبدیل به دیالوگ دوطرفه سنتز صوت طبیعی پردازش بالایی دارد و معمولاً ۱۵ تا ۲۵ درصد از ظرفیت دوره جاری را مصرف میکند.
- فلشکارت یا آزمون (Quiz/Flashcard): پردازشهای کمحجمتر روی متن که بین ۳ تا ۷ درصد سهمیه کسر میکنند.
ساختار بازنشانی دورهای: پنجرههای ۵ ساعته و هفتگی
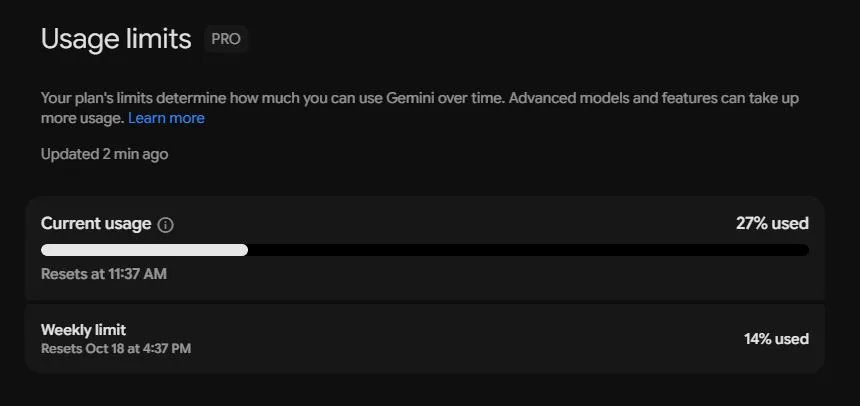
الگوی سهمیهبندی کاربران شخصی در داشبورد اختصاصی مدیریت مصرف بر دو معیار زمانی تنظیم شده است:
- سقف مصرف جاری (Current usage): سهمیه پایهای که هر ۵ ساعت یکبار بازنشانی میشود.
- سقف کلی هفتگی (Weekly limit): محدودیت تجمیعی در طول هفته جهت جلوگیری از سوءاستفادههای رباتیک و بار نامتعارف ابری.
- داشبورد میزان مصرف لحظهای: کاربران اکنون میتوانند درصد مصرفشده و زمان دقیق آزادسازی ظرفیت پردازشی بعدی را مشاهده کنند.
تفکیک طبقات اشتراک و دسترسی مدلها
گوگل دسترسی به ظرفیت پردازش و مدلهای پیشرفته را مستقیماً به سطوح اشتراک گره زده است. در حسابهای Google AI Pro (که سقف مصرف آنها ۴ برابر پلن استاندارد است) و Ultra (که ۵ تا ۲۰ برابر ظرفیت دارند)، درصدهای اشارهشده در قسمتهای قبل بر ظرفیت بزرگتری تقسیم میشوند.
بهعنوانمثال، اگر ساخت یک اسلاید دک یا اجرای تحلیل عمیق در حساب رایگان ۲۰ درصد سهمیه ۵ ساعته را پر کند، در پلن Pro تنها حدود ۵ درصد از سهمیه مصرفی کاربر را به خود اختصاص خواهد داد. همچنین قابلیت Generate Later در ابزارهایی مانند نوتبوک به کاربر اجازه میدهد پردازشهای سنگین (مانند پادکست و اسلاید) را برای زمانهای آزادشدن سهمیه زمانبندی کند.
| سطح حساب کاربری | سقف مصرف محاسباتی | دسترسی و ویژگیهای عملیاتی |
| رایگان (Standard) | سهمیه استاندارد پایه | در دورههای اوج تقاضا محدودتر شده و عمدتاً به مدلهای سبکتر (نظیر Flash-Lite) هدایت میشود. |
| Google AI Plus | ۲ برابر سقف استاندارد | اولویت در صف پردازش و پنجره زمینه ارتقایافته. |
| Google AI Pro | ۴ برابر سقف استاندارد | دسترسی پایدار به مدلهای پرچمدار، توانایی اجرای کامل Deep Research و تحلیل اسناد پرحجم. |
| Google AI Ultra | ۵ تا ۲۰ برابر نسبت به Pro | بالاترین سطح اولویت سازمانی و تخصیص سهمیه گسترده تولید چندرسانهای. |
مکانیزمهای تنزل هوشمند
در هنگام اتمام سقف ۵ ساعته یا هفتگی، دسترسی کاربر به طور کامل مسدود نمیشود؛ بلکه سیستم از قابلیت تنزل (Graceful Degradation) به مدلهای بهینهتر مانند Flash-Lite استفاده میکند تا امکان ادامه مکالمه و پاسخدهی به کارهای ضروری فراهم بماند.
همچنین قابلیتی جهت تنظیم میزان تلاش مدل (Model Effort Setting: Low/Medium/High) اضافه شده که به کاربر امکان میدهد با انتخاب خروجیهای کمهزینهتر، سهمیه خود را مدیریت کند.
این سیاستها نشاندهنده بلوغ اقتصادی هوش مصنوعی در زیرساخت گوگل است؛ رویکردی که تلاش دارد با کنترل هزینه سرسامآور استنتاج مدلهای زبانی بزرگ، تعادلی میان خدمات رایگان و تضمین کیفیت برای مشترکان پرداختی ایجاد کند.