کالبدشکافی چالشهای مهندسی داده و اخلاق بالینی در رویداد تخصصی AI Bridge 2026 اصفهان
بنبست دادههای موازی و رؤیای جراحی هوشمند؛ تبیین واقعیتهای پنهان هوش مصنوعی در نظام سلامت
امین رضا کیفرگیر
- ۲۵ شهریور ۱۴۰۵
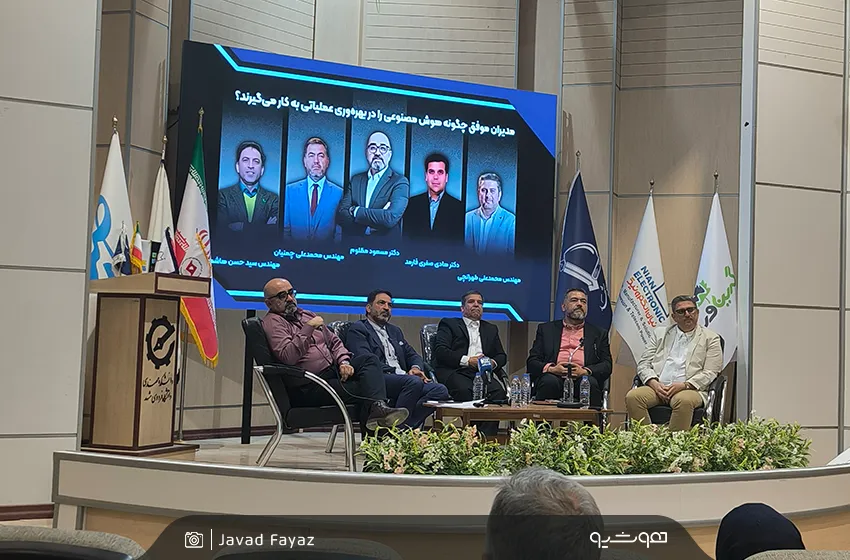
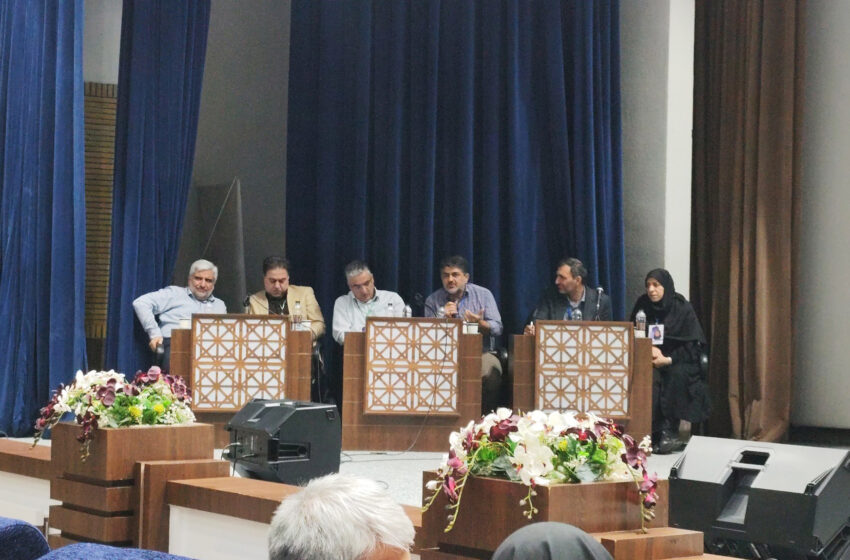
اصفهان – در جریان همایش AI Bridge، بخش گفتوگوی پنل هوش مصنوعی در سلامت به یکی از واقعبینانهترین و چالشبرانگیزترین کانونهای نقد سیاستگذاری فناوری در کشور تبدیل شد. این پنل که با حضور مدیران ارشد درمانی، مهندسان سیستمهای بیمارستانی، اساتید بیومدیکال و توسعهدهندگان بخش خصوصی برگزار گردید، مرزهای میان شور هیجانی رسانهای و حقیقتهای عملیاتی را کالبدشکافی کرد.
در این نشست، متخصصان با تکیه بر تجارب زیسته خود نشان دادند که چگونه فقر کیفیت در دادههای بالینی، انحصارطلبی سازمانها و فقدان حاکمیت داده، سدی جدی در برابر بومیسازی ابزارهای هوشمند ایجاد کرده است. گزارش تحلیلی پیشرو، روایتی مطبوعاتی و مستند از اظهارات کارشناسی، تضاد آرا و راهحلهای جایگزین مطرحشده در این نشست تخصصی است.
گذار جهانی به سمت پیشگیری و بحران حسگری بومی
نشست با طرح این پرسش کلیدی آغاز شد که خواستار تبیین وضعیت موجود هوش مصنوعی در سلامت، هم در تراز جهانی و هم در مقیاس داخلی بود. یکی از اعضای پنل در پاسخ به این پرسش، به پیشتازی چشمگیر حوزه تصویربرداری پزشکی در بازارهای بینالمللی اشاره کرد و توضیح داد که بر اساس آمارها، نزدیک به ۷۰ درصد از اختراعهای ثبت شده در قلمرو هوش مصنوعی سلامت به دلیل پیشرفت در استانداردسازی فرایندهای مهندسی، مربوط به لایه تصاویر پزشکی است.
این کارشناس با تبیین زنجیره ارزش هوش مصنوعی از دریافت داده تا پایشهای پس از استقرار، از تحول عمیق در لایه ابتدایی زنجیره یعنی حسگری (Sensing) سخن گفت.
به گفته وی، ورود ابزارهای پوشیدنی و سنسورهای همراه موجب شده تا پیشبینی شود جریان اصلی مخارج بهداشتی در دنیا طی سالهای آینده به جای درمانهای گرانقیمت، به سمت لایههای پیشگیری و بهداشت سوق یابد.
وی با انتقاد از وضعیت سرمایهگذاری بومی تشریح کرد که در کشور ما در حوزههای حساسی مانند پزشکی شخصیسازی شده سرمایهگذاری ساختاری صورت نگرفته است، چرا که این قبیل حوزهها نیازمند سیاستگذاری کلان در بدنه وزارت بهداشت هستند تا پلتفرمهای مربوطه بتوانند مانند رسانهها مسیر رشد خود را پیدا کنند.
چالش چندپارگی سیستمها و بنبست حاکمیت داده
همچنین در این بخش از پنل، دکتر «عبدالمهدی بقایی»، معاون درمان تأمین اجتماعی استان اصفهان، با نگاهی عملگرایانه به ارزیابی چالشهای دادهای در بیمارستانهای ملکی پرداخت. دکتر بقایی با صراحت اعلام کرد که جریان مدیریت دادهها سالهاست که در کشور معطل مانده و وضعیت دانشگاههای علوم پزشکی نیز تفاوت چندانی با سامانههای تأمین اجتماعی ندارد. وی ریشه اصلی این بحران را در نقص حاکمیت داده در کل کشور و انحصارطلبی سازمانها دانست که هر گروه دادههای خود را نزد خود حبس کرده و از اشتراکگذاری آنها خودداری میکنند. به گفته او، حتی در سطح استان اصفهان نیز یک واحد مرکزی متولی برای مدیریت و انسجام دادههای سلامت وجود ندارد و سامانههای موازی مانند سیب، الو، روز و رسا به صورت جزیرهای و بدون تبادل داده به ثبت اطلاعات مشغول هستند.
در واکنش به این انتقادها، یکی از حاضران در پنل رویکرد متفاوتی را پیشنهاد داد و توصیه کرد که سازمانها نباید کار پژوهشی را معطل استقرار صددرصدی قوانین حاکمیت داده نگه دارند، چرا که داده پدیدهای کاملاً پویا است. این متخصص با ارجاع به مدل چابکی (Agility) در مهندسی نرمافزار، استقرار انبار داده یا هوش تجاری (BI) را فارغ از میزان قدرت آن، نقطه آغاز مناسبی برای پیادهسازی مدلهای هوشمند خواند.
با این حال، دکتر بقایی با تشریح تجربه زیسته خود در تأمین اجتماعی اصفهان پاسخ داد که با وجود برخورداری از زیرساخت BI خوب، سیستم به دلیل ضعفهای سختافزاری و حجم بار کاری شدید، از ساعت ۹ صبح به بعد توان پاسخگویی به درخواستها را از دست میدهد و علاوه بر این، محدودیتهای دسترسی، امکان تحلیلهای مقایسهای فراتر از مرزهای استان را سلب میکند. در ادامه، یکی دیگر از اعضای پنل یادآور شد که سازمانها میتوانند کار را از یک بستر مینیمال و پروندههای دیجیتالی شده یک بیمارستان منفرد آغاز کنند تا فرایند به مرور زمان چرخه اصلاح دادهها را به حرکت درآورد.
سندرم دادههای بزرگ بیکیفیت و توهم گمنامسازی
یکی از پزشکان حاضر در همایش، زاویه دید بالینی و نگرانکنندهای را به بحث اضافه کرد. این پزشک با تبیین تفاوت چشمگیر میان دادههای مالی و بالینی توضیح داد که دادههای بخش مدیریت و اقتصاد بیمارستانها به دلیل ارتباط مستقیم با تراکنشهای مالی با دقت بالایی ثبت میشوند، اما دادههای پزشکی و بهداشتی از کیفیت بسیار پایینی برخوردار بوده و فاقد ارزش پژوهشی هستند.
وی به عنوان نمونه به ثبت دستی و صوری فشار خون بیماران در مراکز بهداشتی و عدم نظارت کیفی بر کار مسئولان ثبت کدهای تشخیصی (لیبلگذاری) اشاره کرد و هشدار داد که این بیدقتی حتی ارزش دادههای دقیق مالی را مخدوش میسازد؛ به طوری که اگر پژوهشگری بخواهد نرخ پرداخت از جیب (Out of Pocket) بیماران دیابتی را بسنجد، به دلیل برچسبهای تشخیصی غلط در پروندهها، به نتایج کاملاً انحرافی خواهد رسید.
این درمانگر اورژانس با ذکر مثالی عینی اظهار داشت که در سیستم مدارک پزشکی، علت فوت یک بیمار مسن و دیابتی که پس از سقوط دچار عفونت خون (سپسیس) شده است را صرفاً «ایست قلبی ریوی» ثبت میکنند که این امر موجب گم شدن علت اصلی مرگ و پدید آمدن پدیده کلاندادههای بزرگ اما غیرقابل استفاده (Big Garbage Data) در کشور میشود. وی با مقایسه تاریخی این روند افزود اسلایدهایی که ده سال پیش در دانشگاه با استناد به مراجع آمریکایی برای اثبات بیارزش بودن دادههای بیمارستانی ایران در ریسرچ تدریس میشدند، متأسفانه امروزه نیز همچنان معتبر هستند، در حالی که کشورهای پیشرو این چالشها را حل کردهاند.
در پاسخ به دغدغه ساختاردهی دادهها، یکی از اعضای پنل به لزوم راهاندازی مراکز تخصصی واسط آمادهسازی دادهها اشاره کرد که در دنیا به عنوان ارائه دهنده سرویسهای داده استاندارد (AI-Ready Data) به فعالیت میپردازند و جای خالی آنها در ایران به شدت احساس میشود.
دکتر بقایی نیز با تأیید این موضوع، به نمونههای موفقی از پایاننامههای دکتری اشاره کرد که با استفاده از دادههای تمیز کلینیکهای دیابت تأمین اجتماعی اصفهان به سرانجام رسیدهاند و بر امکان تعریف پروژههای لوکال تأکید کرد.
در ادامه این بخش، مهندس جلالی، مسئول سامانههای بهداشت و درمان دانشگاه علوم پزشکی اصفهان، به اقدامات وزارت بهداشت پس از شکست پروژه یکسانسازی سامانهها اشاره کرد. به گفته مهندس جلالی، تمرکز فعلی بر روی استانداردسازی معطوف شده و پرتال مرجع mazar.beh.gov.ir با ارائه ۷۷ ترمینولوژی استاندارد حوزه سلامت پیادهسازی شده است که همه نرمافزارها موظف به رعایت آن هستند.
وی توضیح داد که گرچه سیستمهای اطلاعات بیمارستانی (HIS) با داشتن حدود ۴۶۰۰ فیلد داده دارای نواقص کیفی هستند، اما دادههای ثبتشده بدون دخالت انسان (مانند خروجی دستگاههای اتوآنالایزر آزمایشگاهی در تست CBC و تصاویر سیستم پکس) به شدت باکیفیت و قابل اعتمادند و پردازش متون تصویربرداری به کمک مدلهای زبانی کوچک تخصصی (SLM) پتانسیل بالایی دارد.
جلالی همچنین با هشدار نسبت به چالش محرمانگی، مفهوم PPDM (Privacy-Preserving Data Mining) را تشریح کرد و گفت برخلاف تصور عامه، حذف کدملی یا نام بیمار برای گمنامسازی کافی نیست، چرا که تحلیلگران میتوانند با کنار هم قرار دادن چند متغیر غیرمستقیم، هویت بیمار را کشف کنند. وی سادهترین راهکار انتخابی برخی سازمانها یعنی قطع کامل دسترسی به دادهها به بهانه صیانت را به خاموش نگه داشتن کامپیوتر برای جلوگیری از ویروس تشبیه کرد و خواستار تشکیل مراکز پیشرو محلی برای شکستن این بنبست شد.
مدلهای ریاضی تطبیقی و هوش مصنوعی قابل توضیح (XAI)
در بخش دیگری از پنل، مسیرهای مهندسی جایگزین برای عبور از سد دادههای بزرگ به بحث گذاشته شد. دکتر ایزدی، استاد دانشگاه و متخصص حوزههای بیومدیکال، پیشنهاد داد که پژوهشگران به جای متوقف شدن پشت سد دادههای کلان، از مفاهیمی چون مدلهای پیشآموزش دیده (Pre-trained Models) و یادگیری انتقال (Transfer Learning) استفاده کنند.
به باور دکتر ایزدی، نیازهای واقعی کاربران و مدیران معمولاً پس از تماشا و لمس نمونه اولیه (MVP) شکل میگیرد و وقتی پزشک مزایای یک ابزار هوشمند را از نزدیک ببیند، انگیزه بیشتری برای ثبت دادههای دقیق پیدا خواهد کرد.
در تأیید این دیدگاه، یکی از پژوهشگران حوزه مهندسی کنترل و همکار دکتر شاهی، به تشریح کاربرد هوش مصنوعی در لایه کمتر پرداخته شده «مداخله و درمان» (Intervention) مانند کنترل لرزش پارکینسون، حملات صرع، تنظیم دوز داروی اماس یا کنترل عمق بیهوشی با تزریق داروی پروپوفول پرداخت.
این پژوهشگر توضیح داد که آنها موفق شدهاند با استفاده از روشهای کنترل تطبیقی (Adaptive Control) و مدلهای ریاضی ساده بیماریها، وابستگی به دادههای کلان بالینی را در فرایندهای درمانی به شدت کاهش دهند و اثر دادههای بیکیفیت را در مهندسی سیستم جبران کنند.
دکتر برکتیان، از اعضای پنل بعدی، ابعاد فنی بحث را به سمت هوش مصنوعی قابل توضیح (Explainable AI) هدایت کرد. دکتر برکتیان با تأکید بر اینکه پزشکی علمی مبتنی بر شواهد بالینی است، فرضیه جایگزینی کامل پزشک توسط هوش مصنوعی را مردود دانست. او با تشریح پیچیدگیهای چندعاملی در بیماریهایی نظیر سرطان سینه، عدم امکان ادغام دادهها (Data Integration) و ادغام دادههای چندبعدی (Data Fusion) را یک چالش جهانی خواند که حل آن نیازمند منابع پردازشی و جیپییوهایی فراتر از توان کنونی بشر است؛ بنابراین او نیز تمرکز بر روی مدلهای زبانی کوچک تخصصی (SLM) را در بازه فعلی منطقیترین استراتژی دانست.
دکتر رضایتخواه نیز با تأیید این نکات نسبت به راهاندازی شتابزده سامانههای ملی ناقص که سیستم بهداشت کشور را سالها آویزان نگه میدارند هشدار داد.
چتباتهای بیمارستانی و مرز باریک میان خطا و مرگ بیمار
یکی از بخشهای تکان دهنده همایش، زمانی رقم خورد که یکی از توسعهدهندگان حاضر در سالن، تجربیات ششماهه خود را در پیادهسازی یک چتبات هوش مصنوعی بر روی ۳۰ سال دادههای بیمارستانی در اصفهان به اشتراک گذاشت. این توسعهدهنده با تبیین بنبستهای خود در پیدا کردن سیستم OCR قوی برای خواندن دستخط پزشکان، ابراز داشت که در پروژههای صنعتی غیرپزشکی خطاها خسارت مالی به بار میآورند، اما در حوزه سلامت، یک خطای چتبات در ردیابی تداخل دارویی مستقیماً با جان بیمار بازی میکند؛ به طوری که به جای تحلیل داده باید به فکر «کاور جسد» برای بیمار بود. وی از مقاومت مدیران و عدم درک اهمیت استقرار مهندسی داده گله کرد.
دکتر بقایی در پاسخ به این توسعهدهنده تأکید کرد که حتی در صورت دستیابی به سیستم خوانش صددرصدی دستخط پزشکان، تا زمانی که متن نوشته شده استانداردسازی نشود و تشخیصها برچسبهای معتبر نخورند، اطلاعات برای هوش مصنوعی فاقد ارزش خواهند بود. وی خاطرنشان ساخت که گرچه سامانههای جدید فرایند دستورات دارویی و فرایندهای بستری را الکترونیکی کردهاند و این یک گام به جلو است، اما سامانههای کنونی هنوز سیستم پایش خودکار تداخلات دارویی را فعال ندارند.
نقشه راه عملیاتی برای استارتآپهای بهداشت و درمان
دکتر رضایتخواه در بخش پایانی نشست، به ارائه یک جمعبندی کاربردی و نقشه راه برای استارتآپهای نوپا پرداخت. وی با استناد به الگوهای موفق جهانی توضیح داد که هوش مصنوعی در حوزه سلامت معمولاً از بخشهای ستادی و اداری (Back-office) آغاز شده و سپس به سمت لایههای بالینی حرکت کرده است، چرا که تشخیص بالینی به دلیل حساسیتهای جانی بسیار پیچیده است.
او پیشنهاد داد که شرکتهای بخش خصوصی کار خود را از مسائل سادهتر مانند سیستمهای تبدیل گفتار به متن برای گزارشنویسی پزشکی (Voice-to-Text) آغاز کنند که نیازی به مجوزهای سختگیرانه وزارت بهداشت ندارد و بازار به شدت تشنه آن است.
وی با ارائه آماری از گزارش مکنزی به پتانسیل صرفهجویی سالانه ۳۶۰ میلیارد دلاری هوش مصنوعی در سیستم درمانی ایالات متحده اشاره کرد و افزود اختصاص ۴۶ درصد از کل سرمایهگذاریهای خطرپذیر (VC) حوزه سلامت به هوش مصنوعی، نشان دهنده ارزش اقتصادی عظیم این بازار است. به باور وی، تلاقی نخبگان فنی و کادر درمان فرصت بزرگی برای کشور است، اما بقا در کسبوکار پیچیده سلامت، صبوری و یافتن راهکارهای تعاملی را میطلبد.