روبوتاکسی تسلا و چالشهای پیشرو
ایلان ماسک از دو نوآوری جذاب رونمایی کرد: روبوتاکسی و خودروی بزرگتر به نام روبوان؛
ایلان ماسک از دو نوآوری جذاب رونمایی کرد: روبوتاکسی و خودروی بزرگتر به نام روبوان؛
انتظار بالا از هوش مصنوعی مولد به نظارت انسانی زیادی نیاز دارد که خود در تضاد با بهرهوری است.

۲۵ سال پیش، غول تولید تراشه انویدیا (NVDA) GeForce 256، اولین واحد پردازش گرافیکی (GPU) جهان را معرفی کرد.
مدل جدید OpenAI با نام «o1» به تازگی منتشر شده و ادعا میکند که قادر به «استدلال» و حتی «تفکر» است، اما این ادعا با شک و تردید مواجه شده است.
مایکروسافت هفته گذشته اعلام کرد که با Constellation Energy برای راهاندازی مجدد یک رآکتور هستهای در جزیره Three Mile توافق کرده است؛ این توافق به منظور تأمین نیازهای فزاینده برق مراکز داده بوده است.

مجموعه سهاب با بهرهگیری از هوش مصنوعی و سرویسهای ابری، تحولی بزرگ در ارائه خدمات نرمافزاری ایجاد کرده و توانسته نیازهای توسعهدهندگان را باکیفیت و پایداری بالا تأمین کند. راهبر استراتژیک بازارچه سهاب، از برنامههای آینده این پلتفرم برای توسعه سرویسهای هوشمند و گسترش آن به سطح بینالمللی خبر داد.
اکتشاف علمی یکی از پیچیدهترین فعالیتهای انسانی است. ابتدا، دانشمندان باید دانش موجود را درک کرده و شکاف چشمگیری را در بین دانستهها بشر شناسایی کنند. سپس، باید پرسشی پژوهشی طرح و آزمایشی برای یافتن پاسخ طراحی و انجام دهند. سپس، باید نتایج آزمایش را تحلیل و تفسیر کنند که ممکن است پرسشهای تحقیقاتی دیگری را مطرح کند.

دانشمندان امیدوارند با دسترسی به بیش از ۱.۶ میلیون اسکن مغزی جمعآوریشده از بیماران در سراسر اسکاتلند بتواند به پیشبینی خطر ابتلای افراد به زوال عقل کمک کند. تیمی متشکل از ۲۰ محقق از دانشگاههای ادینبورگ و داندی موفق به کسب مجوزی بیسابقه برای بررسی این تعداد عظیم از اسکنهای مغز به صورت ناشناس شدهاند که در طول یک دهه از سراسر جمعیت اسکاتلند جمعآوری شدهاند.
مدلهای زبانی در هوش مصنوعی تحولات بزرگی را در چند سال اخیر تجربه کردهاند و به طرز چشمگیری دنیای هوش مصنوعی را متحول کردهاند. این مدلها که بهمنظور درک و تولید و پردازش زبان انسان طراحی شدهاند، روزبهروز در کاربردهایی نظیر پردازش زبان طبیعی، ترجمۀ ماشینی و حتی نوشتن خلاقانه مهارت و تنوع بیشتری پیدا میکنند. این مقاله به بررسی تکامل مدلهای زبانی در هوش مصنوعی، از روزهای اولیه تا قابلیتهای پیشرفته امروزی، میپردازد.
در جولای 2024، متا جدیدترین مدل پیشرفته خود، لاما 3.1 با 405 میلیارد پارامتر را به همراه نسخههای کوچکتر آن، لاما 3.1 70B و لاما 3.1 8B منتشر کرد. این انتشار تنها سه ماه پس از معرفی لاما 3 صورت گرفت. در حالی که لاما 3.1 405B در اکثر معیارها از GPT-4 و کلود 3 اوپوس پیشی میگیرد و آن را به قدرتمندترین مدل متنباز موجود تبدیل میکند، ممکن است به دلیل زمان تولید کند و زمان بالای اولین توکن (TTFT) برای بسیاری از کاربردهای دنیای واقعی انتخاب مناسبی نباشد.
برخلاف تصور رایج، مدلهای هوش مصنوعی تولیدکننده متن، موجودات باهوش و دارای شخصیت نیستند. این مدلها در واقع سیستمهای آماری پیشرفتهای هستند که وظیفهشان پیشبینی محتملترین کلمه بعدی در یک جمله است. اما مانند کارآموزانی در محیط کاری سختگیر، آنها از مجموعه قوانینی به نام «دستورات سیستمی» پیروی میکنند. این دستورات پایههای عملکردی مدلها را مشخص میکنند و بایدها و نبایدهای آنها را تعیین میکنند.
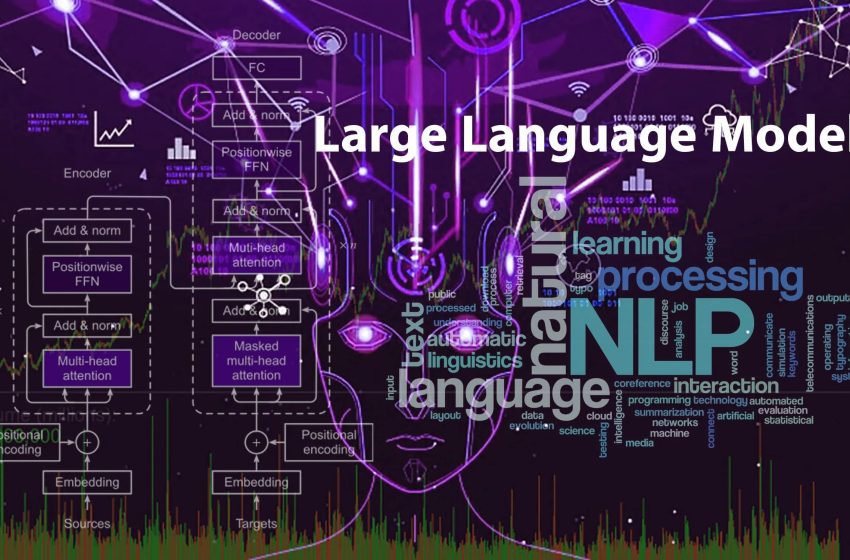
انقلاب کنونی در حوزه هوش مصنوعی مولد، بدون مدلهای زبانی بزرگ (LLM) امکانپذیر نبود. LLMها، مبتنی بر ترانسفورمرها، معماری عصبی قدرتمند، سیستمهای هوش مصنوعی هستند که برای مدلسازی و پردازش زبان انسان استفاده میشوند. آنها به دلیل داشتن صدها میلیون یا حتی میلیاردها پارامتر که با استفاده از مجموعهای عظیم از دادۀ متنی پیشآمدهاند، «مدلهای زبانی بزرگ» یا LLM نامیده میشوند.

کاوش شبکه های اجتماعی و بیرون کشیدن اطلاعات مناسب کسبوکارها با استفاده از دادهکاوی چند سالی است که جایش را در میان شرکتهای بزرگ و کوچک باز کرده است. البته کاربرد تحلیل شبکه های اجتماعی محدود به استخراج اطلاعات مناسب برای کسبوکارها نمیشود و امروز گستره وسیعی را شامل میشود.

این روزها هوش مصنوعی بیشتر از این که یک زمینه علمی باشد، بخشی از زندگی ما شده است. سرویسهای مربوط به برنامههای تلویزیونی از هوش مصنوعی و یادگیری ماشین برای پیشبینی این که دوست دارید برنامه بعدی که تماشا میکنید چه باشد، استفاده میکنند. یکی دیگر از کاربردهای هوش مصنوعی

با گسترش عصر اطلاعات و با توجه به اینکه اکثر این اطلاعات در قالب متن در دسترس همگان هستند، امکان انجام محاسبات روی این متون و درک آنها توسط رایانهها روزبهروز پراهمیتتر میشود. درواقع، پردازش زبان طبیعی (NLP Natural Language Processing) زیرشاخهای از هوش مصنوعی و زبانشناسی است که سعی

رقابت غولهای تکنولوژی جهان بر سر دستیابی به نافذترین دستیارهای صوتی، در دوره حاضر شدت قابلتوجهی یافته است. به نحوی که در کنار آمازون، سایر شرکتها نظیر گوگل، مایکروسافت و اَپل نیز برای طراحی بهترین دستیارهای صوتی میکوشند. این موضوع علاوه بر تولید ارزش افزوده، توانسته است سرعت رشد و

خواندن آهنگ الفبا از اولین دروسی است که کودکان باید بیاموزند. اهمیت این درس و یادگیری زبان اشاره برای خانوادههایی که کودک ناشنوا یا کمشنوا دارند، به هیچوجه کمرنگتر نیست. در این شرایط، زبانهای بصری جای محرکهای شنیداری را گرفته و نقشی حیاتی در رشد اولیهی کودک ایفا میکنند. استودیوی

من برای اولین بار از طریق کانال یوتیوب Qoves Studio با این کسبوکار آشنا شدم؛ در این کانال که میلیونها بازدیدکننده دارد ویدئوهایی با مضامینی از قبیل مدل مو چه تأثیری بر زیبایی دارد؟ راز جذابیت تیموتی شالامِی در چیست؟ و جراحی فک چه تأثیری بر مقبولیت اجتماعی دارد؟ بارگذاری

برای اینکه درک بهتری از اهمیت دسته بندی صداها داشته باشید، به این مثال توجه کنید. اتاق کنفرانسی را در نظر بگیرید که یک جلسه در آن درحال برگزاری است. در این اتاق آدمهای زیادی هستند که به نوبت صحبت خواهند کرد. ما میخواهیم در این جلسه هر چه آنها

پیشرفتهایی که اخیراً در انواع شبکه عصبی مولد حاصل شده، تأثیرات شگرفی بر کیفیت و وضوح تصاویر، به ویژه در حوزه تغییر و انتقال سبک Style transfer، داشته است. مشوق اصلی ما برای نگارش مقاله پیشرو، موفقیتهای اخیر StyleGAN بوده است. در مدل StyleGAN، تغییرات تصادفی در تصاویر ایجاد شده

سیستم های امبدد به طور فزایندهای در جنبههای مختلف زندگی بشر نفوذ کردهاند؛ از ماشینها گرفته تا تلفنهای همراه، تجهیزات ویدئویی تا پخشکنندههای MP3 و ماشینهای ظرفشویی تا ترموستاتهای خانگی همگی دارای کامپیوترهای امبدد هستند که توانستند تأثیر بسزایی در کاهش مصرف انرژی و طراحی بهینه تجهیزات گذارند. اما این

شرکتها با تکیه بر تکنیک تحلیل احساسات میتوانند بار عاطفی ارتباطات را تشخیص دهند. درحالحاضر، این فناوری از تحلیل متن فراتر میرود و از دادههای صوتی و تصویری نیز استفاده میکند. تعریف تحلیل احساسات تحلیل احساسات، روشی تحلیلی است که بهمنظور تشخیص معنای عاطفی ارتباطات از آمار، پردازش زبان طبیعی

تحلیل پیشرفته Advanced Analytics یکی از روشهای تحلیل داده است که با تکیه بر مدلسازی پیشبین Predictive modelling، الگوریتمهای یادگیری ماشینی، یادگیری عمیق، خودکارسازی فرآیندهای کاری و سایر روشهای آماری، اطلاعات به دست آمده از منابع گوناگون را تجزیه و تحلیل میکند. تحلیل پیشرفته از روشهای سنتی هوش تجاری (BI) فراتر

برای رسیدن به موقعیت کنونی چه مسیری را طی کردهایم؟ در این مسیر به چه قابلیتهایی دست پیدا کردهایم؟ و چه پیشرفتهایی در انتظار ما است؟ برای پاسخ به این سؤالات باید تاریخچه داده را مطالعه کنیم.

پیش از آنکه به متن کاوی در هوش مصنوعی بپردازیم، باید با مقولهای با نام پردازش زبان طبیعی یاNaturalLanguage Processing (NLP) آشنا شوید. NLP درواقع مقدمهای برای ورود به مبحث متنکاوی بوده و درحقیقت روشی است که از طریق آن میتوان به ارائه مفاهیم به شکلی قابل درک، برای کامپیوترها

در این نوشتار، پروژه یکپارچهای که در رقابتهای Kaggle با موضوع تکنیکهای پیشرفتهی رگرسیون انجام دادم را، به صورت گام به گام، برای مخاطبان توضیح خواهم داد. قرار است مخاطبان بتوانند از این مقاله به عنوان یک دوره آموزشی مختصر در مورد یادگیری ماشین استفاده کنند.

آموزش هکرها برای استفاده از هوش مصنوعی در حمله به امنیت سایبری به یکی از دغدغههای جدی سازمانهای تولید کننده داده تبدیل شده است. AI Fuzzing روشی برای تست عملکرد نرمافزار در حوزه امنیت سایبری در هوش مصنوعی است که توسط سازمانها برای تشخیص آسیبپذیری یا اشکالات یک نرمافزار یا

تابع لاس خوب لزوماً به معنی یادگیری خوب نیست همه مدلهای یادگیری ماشینی در آزمایشگاه کامپیوتر متولد شده و قبل از پیادهسازی، تعریف، آزمایش و بازطراحی میشوند؛ سپس بعد از آموزش مجدد، به دقت تنظیم شده و در نهایت دوباره مورد آزمایش قرار میگیرند. پس از آن، هدف و مأموریت

سؤالاتی از این دست که، محبوبترین ابزار مورد استفاده در داده کاوی چیست؟ یا کدام الگوریتم برای دادهکاوی بهتر است؟ ما را به سمت زبان برنامهنویسی به نام پایتون سوق میدهد، که به صورت خاص آن را برای تجزیه و تحلیل دادهها توسعه دادهاند. قوانین تولیدشده توسط دادهکاوی برای یافتن

مقدمات یادگیری ماشینی: قسمت سوم در این نوشتار، به پیادهسازی معادله نرمالNormal equation میپردازیم که یک راهکار فرمبستهClosed-form solution برای الگوریتم رگرسیون خطی است. با استفاده از معادلات نرمال، میتوانیم مقدار بهینه theta را تنها طی یک مرحله و بدون استفاده از الگوریتم گرادیان کاهشیGradient descent محاسبه کنیم. در ابتدا

در این نوشتار، با پیادهسازی یک الگوریتم غیرپارامتری به نام رگرسیون خطی وزنی محلی آشنا میشویم. بدین منظور، ابتدا نگاهی به تفاوت بین الگوریتمهای یادگیری پارامتری و غیرپارامتری خواهیم انداخت. سپس تابع وزندهی و تابع پیشبینی را توضیح خواهیم داد. در انتها، پیشبینیهای تولیدشده را با استفاده از کتابخانههای NumPy

مقدمات یادگیری ماشینی: قسمت اول در این نوشتار، قصد داریم ابتداییترین مدل یادگیری ماشینی یعنی رگرسیون خطی را بسازیم و آن را تنها با استفاده از کتابخانه Numpy پایتون اجرا کنیم. بدین منظور، ابتدا نگاهی به دیتاست خواهیم انداخت، سپس در خصوص فرایند الگوریتم عمومی یادگیری نظارتشده صحبت خواهیم کرد

دستیار گوگل، سیری (Siri)، الکسا (Alexa) و سایر دستیارهای صوتی همیشه مایه تعجب و شگفتی من بودهاند. این دستیارها با انجام خودکار برخی کارها کمک زیادی به کاربران خود میکنند. به همین دلیل، تصمیم گرفتم برای خودم یک دستیار صوتی بسازم که دستورات صوتی را از طریق میکروفن لپتاپم دریافت

مهمترین سرفصل های علوم داده چیستند؟ این سرفصلها در هر دوره مرتبط با علم داده تدریس میشوند و برای یادگیری این علم، آشنایی با آنها ضرورت دارد؛ نهتنها تحلیلگران داده و متخصصان هوش تجاری، هدفشان ارتقای مهارتها و دانش دادههای خود است، بلکه بازاریابان، مدیران سطح C، سرمایهداران و غیره

«استنتاج» و «استدلال» از جمله مفاهیمی است که تا مدتها، منحصراً در حیطه دانش انسانی طبقهبندی میشد و تصور آنکه روزی ماشینها بتوانند گزارههای متعدد را کنار یکدیگر قرار دهند و از این عمل به نتیجه معقولی و منطقی برسند، دشوار بود. با پیشرفت روزافزون فناوری کامپیوترها، امکان استدلال توسطs

در مقاله حاضر، قصد داریم به آن دسته از پرسشهایی پاسخ دهیم که افرادِ تازه کار با گراف یا شبکه های عصبی گراف مطرح میکنند. در همین راستا، از نمونههای PyTorch برای طبقهبندیِ ایدۀ پشت این نوع مدل نسبتاً جدید استفاده کردهایم. پرسشهایی که در این بخش از مقاله بررسی

اگر مدل آموزشی از تعداد نمونههای بیشتری برخوردار باشد، مدل علم داده بهتری به دست میآید، اما این کار در خصوص برخی از ویژگیها صدق نمیکند. دیتاست حقیقی ویژگیهای گوناگونی دارد و برخی از آنها نقش مفیدی در آموزش مدل علم داده قوی دارند. ویژگیهای حشو یا تکراری نیز بر

خوشه بندی در داده کاوی به عنوان یکی از ابزارهای قدرتمند گروهبندی داده شناخته شده که جهت تشخیص الگوهای نهفته در بین دادهها مورد استفاده قرار میگیرد. از منظر ارتباط با هوش مصنوعی، خوشهبندی نوعی یادگیری بدون نظارت است که بدون وجود دانشی در مورد برچسب دادهها و متغیر هدف،

پیشرفت چشمگیر فناوری پردازش زبان طبیعی (Natural Language Processing) در چند سال اخیر، برای بسیاری از متخصصان علوم داده نیز قابل پیشبینی نبود. فراگیری NLP چنان قابلتوجه بوده که بسیاری از شرکتهای کوچک و بزرگ، تصمیم گرفتند سرمایهگذاری عظیمی بر روی این فناوری انجام دهند و پردازش زبان طبیعی را

شبکههای مولد تخاصمی یا GAN ها گروهی از الگوریتمهای یادگیری عمیق و متعلق به دستهی مدلهای مولد هستند. هدف اصلی مدلهای مولد، توصیف چگونگی تولید یک دیتاست، از نظر قواعد احتمالی، است. بدین طریق هرگاه بر اساس این قواعد احتمال، نمونهگیری انجام دهیم، دیتاستی جدید به دست میآوریم که با