عصر جعل هویت
سید محمدجواد فیاض
- ۱۲ مهر ۱۴۰۵
دیپفیکها (Deepfake) در ابتدا بهعنوان ابزاری برای یک نوع سوءاستفاده خاص و غیراخلاقی گسترش یافتند: تصاویر جنسی تهیهشده بدون رضایت. نسخههای اولیه اغلب از نظر فنی خام بودند، با دستکاریهای آشکار یا صداهایی که چندان واقعی به نظر نمیرسیدند. اما آنچه اکنون تغییر کرده، موتور محرک پشت این فناوری است.
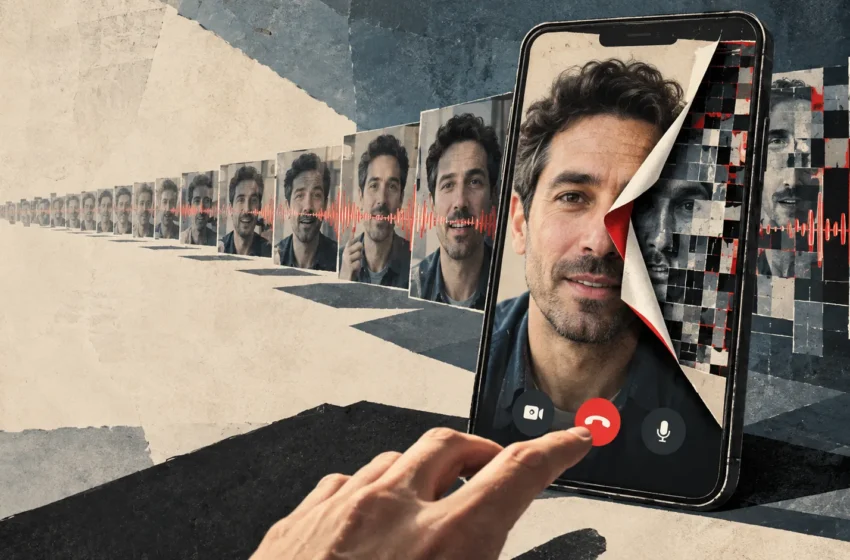
هوش مصنوعی مولد، ساخت محتوای متقاعدکننده را سریعتر و ارزانتر و مقیاسپذیری آنها را بهمراتب آسانتر کرده است و آنچه را که روزگاری نیازمند زمان، مهارت و ابزارهای تخصصی بود، به چیزی تبدیل کرده است که بنا به تقاضا و در لحظه قابلتولید است. دیپفیکهای امروزی در پسزمینه زندگی مدرن رسوخ کردهاند و میانبری برای کلاهبرداران، سلاحی در رسانههای اجتماعی و یک بدلکار در تماسهای تصویری هستند که اعتبار شخص دیگری را غصب میکند. فریبکاری اکنون به یک ویژگی مصرفکننده تبدیل شده است؛ در این محیط، سرعت حرف اول را میزند و تا زمانی که جعلیبودن یک محتوا اثبات شود، آسیب از قبل وارد شده است.
«هانی فرید» (Hany Farid) پژوهشگر پزشکی قانونی دیجیتال در دانشگاه کالیفرنیا سالها زمان خود را صرف مطالعه ردپاهایی کرده است که این سیستمها از خود بر جای میگذارند؛ نشانههایی که دست آنها را رو میکند و اینکه چرا صرفِ تشخیص آنها هرگز راهحل کاملی نیست. او نسبت به هاله ابهام و رازآلود پیرامون هوش مصنوعی بدبین است و ترجیح میدهد از اصطلاح «غلتک توکن» (Token Tumbler) استفاده کند. او به این ایده باور دارد که ما صرفاً با فیلترکردن محتوا میتوانیم راه خود را بهسوی حقیقت باز کنیم. استدلال او سادهتر و درعینحال دشوارتر است؛ اگر دنیایی میخواهیم که در آن شواهد همچنان معتبر باشند، باید قوانین مربوط به مسئولیتپذیری قانونی را بازنویسی کنیم و به سراغ گلوگاههایی برویم که فریب دیجیتال را ارزان و سودآور میکنند. گزارش حاضر در نسخه March 2026 نشریه Scientific American با فرید درباره آینده دیپفیکها و راهکارهای مؤثر برای مقابله با آنها به گفتوگو نشسته است.
متن ویرایششده این مصاحبه در ادامه آمده است:
وقتی در عصر هوش مصنوعی مولد از «زیرساخت اعتماد» سخن میگویید، لایههای اصلی آن در حال حاضر چه چیزهایی هستند؟
آنچه در ۲۰ سال گذشته به لحاظ اطلاعات نادرست در رسانههای اجتماعی تجربه کردهایم، اکنون توسط هوش مصنوعی مولد هدایت میشود؛ رباتهای پیچیدهتر، تصاویر جعلی، ویدئوهای جعلی، همه چیز جعلی. در اینجا باید به تلاقی توانایی تولید تصویر، صدا و ویدئو از هر کسی در حال گفتن و انجام هر کاری و کانالهای توزیع رسانههای اجتماعی که با هم ترکیب میشوند، فکر کنید. منظور من از «اعتماد»، پاسخ به این پرسش است که چگونه میتوانید به هر چیزی که در فضای آنلاین میبینید اعتماد کنید.
اعتماد جنبه دیگری نیز دارد که برای مثال در صحن دادگاه مطرح میشود. چگونه به شواهد در یک پرونده حقوقی، یک پرونده کیفری، یا یک پرونده امنیت ملی اعتماد میکنید؟ اکنون چه باید کرد؟ برخی از وکلا میگویند: «خب، ما این فایل صوتی را داریم، این تصویر را داریم و این ویدئوی دوربین مداربسته را داریم؛ بسیار خب، حالا چهکار کنیم؟»
این واقعیت نیز وجود دارد که چتباتها از حالت حاشیهای خارج شده و به طور کامل یکپارچه و ادغام خواهند شد. پس چه اتفاقی میافتد وقتی شروع به ساخت نسل بعدی همه چیز میکنیم؛ از خودروهای خودران گرفته تا کدهایی که مینویسیم اکنون با هوش مصنوعی آمیخته شدهاند و زمانی که قرار است این سیستمها را در نقطهای به زیرساختهای حیاتی بسپاریم، دیگر چگونه میتوانیم به آنها اعتماد کنیم؟
فکر میکنید بزرگترین سوءتفاهم اغلب مردم درباره هوش مصنوعی مولد امروزی چیست؟
فکر میکنم بزرگترین تصور اشتباه این است که این فناوری، هوش مصنوعی است. اصطلاح موردعلاقه من برای آن «غلتک توکن» است. کاری که آنها انجام دادهاند این است که حجم عظیمی از متن را جمعآوری کرده، کلمات را به توکنهای عددی تقلیل داده و سپس یک تکمیل خودکار (Auto-complete) پیچیده را اجرا میکنند: «بسیار خب، من این توکنها را دیدهام. توکن بعدی چیست؟» این سیستم قطعاً مصنوعی است، اما مسلماً هوشمند نیست.
موضوع دیگری که مردم باید درک کنند این است که بخش اعظم این «هوشمندی» در کامپیوتر نیست و در واقع در انسانهاست. استخراج دادهها و ساخت یک غلتک توکن، شما را به ChatGPT نمیرساند. راه رسیدن به ChatGPT این است که تعداد زیادی انسان را وارد کار کنید تا پرسشها و پاسخها را بهصورت دستی حاشیهنویسی کنند و بگویند: «این یک پاسخ خوب است؛ آن یک پاسخ بد است.» این همان چیزی است که فاینتیون و «یادگیری تقویتی» (Reinforcement Learning) نامیده میشود.
بزرگترین آسیبهایی که در حال حاضر مشاهده میکنید کداماند؟
خب، تصاویر خصوصی تهیهشده بدون رضایت، یا NCII، وحشتناک است. سوءاستفاده جنسی از کودکان، اخاذی جنسی، کودکانی که با چتباتها صحبت میکنند و چتباتها آنها را متقاعد میکنند که به زندگی خود پایان دهند؛ اتفاقاتی هستند که رخ دادهاند و پروندههای حقوقی نیز مربوط به همین موارد است. کلاهبرداری اکنون توسط هوش مصنوعی مولد در قالب کلاهبرداریهای صوتی در سطح فردی بهشدت تقویت شده است. علاوه بر این، باید به کمپینهای انتشار اطلاعات نادرست و مسمومکردن اکوسیستم اطلاعاتی نیز اشاره کنم.
ازآنجاییکه من یک استاد دانشگاه هستم، باید بگویم که نباید تأثیر آن بر آموزش را دستکم بگیرید. منظورم این است که هیچ دانشجویی وجود ندارد که از هوش مصنوعی استفاده نکند و شما نمیتوانید بگویید: «هر کاری دلتان میخواهد بکنید.» ما باید به طور اساسی در نحوه آموزش به دانشجویان تجدیدنظر کنیم؛ نهتنها برای آمادهکردن آنها برای آیندهای که این ابزارها تقریباً بهطورقطع در کنارشان خواهند بود، بلکه برای اینکه مشخص کنیم آنها چه چیزی را باید یاد بگیرند.
برای حذف تصاویر خصوصی تهیهشده بدون رضایت، در حال حاضر بهترین رویکرد اجرایی چیست و ضعیفترین حلقه کجاست؟
در تمام لایههای این سیستم مقصرانی وجود دارند؛ از شخصی که دستش روی کیبورد است تا محصولی که ساخته شده تا شرکتهایی که آن را میزبانی میکنند و البته رسانههای اجتماعی که اجازه میدهند همه این موارد منتشر شوند. در این زنجیره، همه به درجات مختلف مقصر هستند.
آیا تطبیق هش (Hash Matching)، مبتنی بر شناسایی «اثر انگشت» دیجیتال در فایلهای رسانهای مؤثر است یا در این مرحله صرفاً یک مبارزه بیحاصل است؟
من بخشی از تیم مایکروسافت بودم که در گذشته برنامه شناسایی تصویر PhotoDNA را برای انجام تطبیق هش در حوزه سوءاستفاده جنسی از کودکان ساختیم و من همیشه حامی این فناوری بودهام. در فضای سوءاستفاده جنسی از کودکان، جایی که از کودکان واقعی بهرهکشی میشود، این فناوری در واقع نسبتاً خوب کار میکند زیرا میدانیم که همان تصاویر و همان ویدئوها بارهاوبارها دستبهدست میشوند.
اما محتوای NCII امروزی توسط هوش مصنوعی تولید میشود و میتوانید آن را بهصورت انبوه تولید کنید. مشکل تطبیق هش این است که: «بسیار خب، شما قرار است این یک تصویر را بگیرید، اما من میتوانم ۱۰۰ تصویر دیگر را در ۳۰ ثانیه آینده بسازم.» بنابراین تطبیق هش شما را فقط تا سطح خاصی پیش میبرد و ازآنجاییکه افراد اکنون میتوانند این موارد را با سرعت بسیار بالایی بسازند، فکر نمیکنم بتوانید همگام با آنها پیش بروید.
قانونگذاران در لوایح مربوط به دیپفیک چه کارهایی را باید متوقف کنند و چه اقداماتی را باید بیشتر انجام دهند؟
برای شفافیت کامل باید بگویم، من روی نسخههای اولیه «قانون حذف محتوا» (TAKE IT DOWN Act) با اساتید حقوق، «مری آن فرانکس» و «دانیل سیترون» کار کردم. باید بگویم زمانی که شروع شد قانون بسیار خوبی بود، اما در مسیر تصویب نهایی به یک قانون وحشتناک تبدیل شد.
اگر شما سازنده یک اپلیکیشن Nudify باشید، این قانون در واقع شما را پاسخگو نمیداند. یک پنجره زمانی ۴۸ ساعته برای حذف محتوا دارد که مسخره است؛ زیرا اینجا اینترنت است، یعنی همه چیز در ۹۰ ثانیه اول اتفاق میافتد و همین سببِ تمام مبارزات بیحاصل است. مسئله دیگر این است که هیچ جریمهای برای ایجاد گزارشهای دروغین وجود ندارد، به همین دلیل فکر میکنم این قانون بهعنوان یک سلاح مورد سوءاستفاده قرار خواهد گرفت.
بنابراین کاری که باید متوقف کنند تصویب لوایحی ازایندست است که کاملاً ناکارآمد هستند. شما نمیتوانید به سراغ محتوا بروید. شما باید به سراغ زیرساخت بروید؛ شرکتهایی که آن را میزبانی میکنند، فروشگاههای اپل و گوگل و سیستمهای ویزا، مسترکارت و پیپال که امکان درآمدزایی از آن را برای افراد فراهم میکنند. شما باید به سرچشمه بروید. ضمناً، در حال حاضر هنوز بار یافتن محتوا و ارسال اخطاریهها بر دوش قربانیان است.
با پیشرفت هوش مصنوعی مولد، چه چیزی تغییر کرده است و شرکت شما، GetReal، چگونه به آن واکنش نشان میدهد؟
زمانی که در سال ۲۰۲۲ شروع کردیم، تمرکز ما بر تحلیل مبتنی بر فایل بود. شخصی فایل تصویر، صدا یا ویدئو را برای شما ارسال میکند و شما تاحدامکان اصالت آن را تعیین میکنید. اما سپس شاهد حملات لحظهای بودیم که در آن افراد وارد تماسهای Zoom و Teems میشدند و هویت افراد دیگر را جعل میکردند. بنابراین ما کار خود را گسترش دادیم و گفتیم: «ما نمیتوانیم فقط روی فایل تمرکز کنیم. باید روی این جریانهای داده متمرکز شویم» و آنچه اتفاق افتاده همان چیزی است که همیشه در مورد فناوری رخ میدهد؛ یعنی بهتر، سریعتر، ارزانتر و همهگیرتر میشود.
ما رویکرد «اولویت پزشکی قانونی دیجیتال» را اتخاذ میکنیم. ما میپرسیم: مصنوعات (نشانگرها) و ردپاهایی که نهتنها در این یک ویدئوی Sora بلکه در همه مدلهای مولد ویدئو، صدا و تصویر میبینید چیست؟ ما یک ردپای پزشکی قانونی پیدا میکنیم که معتقدیم حتی پس از فشردهسازی مجدد، تغییر اندازه و دستکاری فایل قادر به اندازهگیری آن خواهیم بود و سپس تکنیکهایی را برای یافتن آن نشانگر میسازیم. وقتی من برای ادای شهادت به دادگاه میروم، به قاضی و هیئتمنصفه نمیگویم: «خب، من فکر میکنم این محتوا جعلی است؛ چون کامپیوتر به من اینطور گفته است.» من میگویم: «من فکر میکنم این محتوا جعلی است؛ چون ما به دنبال این نشانگرهای خاص گشتیم و نگاه کنید، ما آن نشانگر را پیدا کردیم.»
دو سال دیگر چه شرایطی باید مهیا باشد تا بتوانید بگویید ما یک زیرساخت اعتماد کارآمد ایجاد کردهایم؟
دو نوع اشتباه وجود دارد که میتوانید مرتکب شوید. شما میتوانید بگویید یک چیز واقعی، جعلی است که به آن مثبت کاذب (False positive) میگوییم و میتوانید بگویید یک چیز جعلی، واقعی است که به آن منفی کاذب (False negative) میگوییم. سختترین کار پایین نگهداشتن این مثبتهای کاذب است. اگر هر بار که وارد تماسی میشوید فناوری بگوید: «جعلی است»، شما بهسادگی آن را نادیده خواهید گرفت؛ شبیه صدای دزدگیر ماشینها در خیابان.
بنابراین مثبتهای کاذب باید پایین باشند. بدیهی است که باید همگام با فناوری پیش بروید و باید افراد مجرم را دستگیر کنید. این فرایند باید سریع باشد، بهویژه در یک جریان داده. نمیتوانید ۱۰ دقیقه صبر کنید و من فکر میکنم باید توضیحپذیر (Explainable) باشد. شما نمیتوانید به دادگاه بروید یا با مقامات CIA یا آژانس امنیت ملی (NSA) صحبت کنید و بگویید: «خب، این جعلی است؛ چون ما اینطور میگوییم.» قابلیت توضیحپذیری واقعاً اهمیت دارد.
اکنون، خبر خوب این است که من فکر میکنم در عین تناقص، ما پیش از فایلها به جریانهای امن داده دست خواهیم یافت. در یک جریان داده، فرد مجرم باید محتوای جعلی را در لحظه تولید کند. من میتوانم پنج ثانیه صبر کنم که معادل صدها فریم است؛ اما در مورد یک فایل، مجرم میتواند در آرامش خانه خود بنشیند و تمام روز برای ایجاد یک محتوای جعلی بسیار باکیفیت کار کند و سپس آن را منتشر کند. در GetReal ما محصولی داریم که روی تماسهای Teams، Zoom و WebEx قرار میگیرد و جریانهای صوتی و تصویری را با دقت بسیار بالایی تحلیل میکند.
اگر بتوانید تنها یک چیز را در پلتفرمها یا اپلیکیشنها تغییر دهید تا از مردم با بیشترین سرعت محافظت کنید، چه چیزی خواهد بود؟
ابتدا من مسئولیت قانونی (Liability) ایجاد میکردم. قوانین قرار نیست این کار را انجام دهند. شما محصولی میسازید که آسیب میرساند و میدانستید یا باید میدانستید که چنین میکند و من شما را چنان تحت پیگرد قانونی قرار میدهم که به عصر تاریکی برگردید؛ همانطور که در دنیای فیزیکی این کار را میکنیم. ما هنوز این رویه را در دنیای دیجیتال اعمال نکردهایم.
آیا این پلتفرمها تحت حمایت «ماده ۲۳۰» نیستند، قانونی که پلتفرمهای اینترنتی را در برابر محتوای ارسالشده توسط کاربرانشان از مسئولیتپذیری مصون میکند؟
ماده ۲۳۰ بهاحتمال زیاد از شما در برابر هوش مصنوعی مولد محافظت نمیکند، زیرا هوش مصنوعی مولد محتوای شخص ثالث نیست؛ بلکه محتوای شماست. شما آن را ایجاد کردهاید؟ شما اپلیکیشنی ساختهاید که نامش Nudify است، چتبات شما همان چیزی است که به کودک گفته خودش را بکشد و درباره آن مکالمه به والدینش چیزی نگوید. این محصول شماست و ضمناً، من بسیار مشتاق اصلاح ماده ۲۳۰ هستم تا شرکتهایی مثل فیسبوک، توییتر و تیکتاک را مسئول و پاسخگو نگه دارد.
یک اقدام محافظتی خوب دیگر همان کاری است که استرالیا انجام داد؛ یعنی ممنوعیت رسانههای اجتماعی برای کودکان زیر ۱۶ سال. رسانههای اجتماعی برای کودکان یک آزمایش بود که جواب نداد. این امر یک فاجعه است و شواهد آن قاطع و غیرقابلانکار است.
به خانوادهها درباره کلاهبرداریهای شبیهسازی صدا چه میگویید؟
من عاشق کلمات ایمنی (کلمات رمز) هستم. این یک راهحل آنالوگ برای یک مشکل دیجیتال و یک راهکار با فناوری پایین است. توصیه دیگری که به همه میکنیم این است که آگاه بمانند. بدانید که این اتفاق در حال رخدادن است. بدانید که قرار است ساعت دو صبح تماسی از پسرتان دریافت کنید که چیز وحشتناکی میگوید؛ پس تلفن را قطع کنید و دوباره با او تماس بگیرید. این وضعیت شبیه به تمام موارد در امنیت سایبری است؛ روی لینکها کلیک نکنید. آگاهی عمومی مشکل را حل نمیکند، اما تأثیر آن را به حداقل میرساند و کار را برای افراد مجرم کمبازدهتر میکند.
آیا شما و همسرتان در هر تماس، در هر تبادل دیجیتالی از کلمه امن (رمز) استفاده میکنید؟
فقط درصورتیکه اتفاق دراماتیک و غیرمنتظرهای بیفتد. این یک فرضیه نیست و من خودم مورد حمله یک کلون صوتی قرار گرفتم. وکیلی که در یک پرونده بسیار حساس با او کار میکردم، تماسی از شماره من دریافت کرد که با صدای من درباره آن پرونده صحبت میکرد. در مقطعی او مشکوک شد و با من تماس گرفت و گفت: «تو بودی؟» من گفتم: «درباره چه چیزی صحبت میکنی؟» بنابراین من و او برای بقیه مراحل آن پرونده یک کلمه رمز تعیین کردیم. برای من و همسرم، این کلمه رمز برای مواقعی است که کسی میگوید: «من تصادف کردهام»، «من دزدیده شدهام» و ازاینقبیل چیزها.
در میان کسانی که از هوش مصنوعی بهعنوان یک تهدید وجودی میترسند و کسانی که معتقدند موج کنونی تماماً هیاهو است، شما در چه جایگاهی قرار میگیرید؟
اگر با افراد فعال در فضای فناوری صحبت کنید، به نظر میرسد دو جبهه اساسی ضد هوش مصنوعی وجود دارد. یک جبهه با حضور «جفری هینتون» دانشمند علوم کامپیوتر و پیشگام هوش مصنوعی وجود دارد که میگوید: «اوه خدای من، همه ما قرار است بمیریم. من چهکار کردهام؟» و در سوی دیگر دانشمند علومشناختی، «گری مارکوس» و جبهه او وجود دارد که میگوید: «اینها همه ادعاهای واهی و توخالی است و من ۱۰ سال است که به شما میگویم اینها حقیقت ندارند.»
من فکر میکنم هر دو اشتباه میکنند. من لزوماً فکر نمیکنم که همه ما قرار است بمیریم، اما واضح است که چیزی در حال تغییردادن جهان است. چند سال آینده بسیار جالب خواهد بود. ما باید بهطورجدی درباره آیندهای که میخواهیم فکر کنیم و همین حالا سیستمها را مستقر کنیم. در غیر این صورت، شاهد تکرار ۲۰ سال گذشته خواهیم بود.