یک مقایسه کمی نامطلوب
تفاوت قضاوت انسان و هوش مصنوعی
سید محمدجواد فیاض
- ۲۵ آبان ۱۴۰۵
قراردادن انسانها و مدلهای زبانی بزرگ در آزمونهای استدلال در برابر یکدیگر، تفاوتهای میان آنها را برجسته میکند.
وقتی وارد مطب پزشک میشوید، پیشفرضی آنقدر بدیهی دارید که تقریباً نیازی به بیان آن احساس نمیکنید: پزشک با بدن انسان مواجه شده است. او آناتومی را مطالعه کرده، اندامهای بدن را دیده و تفاوت میان دردی که پخش میشود و دردی که بهصورت ضربانی بروز پیدا میکند را آموخته است. شما تصور میکنید که او این دانش را نهفقط از طریق مطالعه، بلکه در طول سالها تجربه عملی و آموزش به دست آورده است.
حالا تصور کنید متوجه شوید که این پزشک هرگز با یک بدن انسان مواجه نشده است. او صرفاً میلیونها شرححال بیمار را خوانده و با جزئیاتی دقیق آموخته است که یک تشخیص معمولاً «چه حالوهوایی دارد». توضیحات او همچنان میتواند قانعکننده و حتی آرامشبخش به نظر برسد. آهنگ بیان درست خواهد بود، واژگان بینقص خواهند بود و صورتبندی جملات به شکلی اطمینانبخش آشنا به نظر میرسند. اما بهمحض اینکه بفهمید دانش او واقعاً بر چه چیزی استوار است (الگوهای موجود در متن، نه تماس با جهان واقعی)؛ چیزی اساسی از بین خواهد رفت.
هر روز افراد زیادی برای دریافت توصیههای پزشکی، راهنمایی حقوقی، بینشهای روانشناختی، آموزش و تدریس یا قضاوت درباره اینکه چه چیزی درست و چه چیزی نادرست است، به ابزارهایی مانند ChatGPT روی میآورند. آنها در سطحی میدانند که این مدلهای زبانی بزرگ در حال تقلید از درکی از جهان هستند که واقعاً در اختیار ندارند؛ حتی اگر روانبودن و سلاست بیان آنها باعث شود بهراحتی این واقعیت را فراموش کنیم.
اما آیا استدلال یک LLM واقعاً به قضاوت انسانی شباهت دارد، یا این مدل صرفاً شمایل زبانیِ استدلال را تولید میکند؟
نویسنده Scientific American بهعنوان دانشمندی که درباره قضاوت انسانی و پویاییهای اطلاعات مطالعه میکند، اخیراً همراه با همکارانش تلاش کرده به این پرسش که جای تعجب دارد چرا کمتر موردبررسی قرار گرفته، پاسخ دهد. این تیم نحوه پاسخگویی LLMها و انسانها را زمانی که از آنها خواسته میشد در مجموعهای از آزمونهایی که دهههاست در روانشناسی و علوم اعصاب موردمطالعه قرار گرفتهاند، با یکدیگر مقایسه کردند. تیم انتظار نداشت این سیستمها مانند انسانها «فکر کنند»، اما معتقد بود درک تفاوت این ابزارها با انسانها میتواند برای ارزیابی چگونگی و زمان استفاده از آنها ارزشمند باشد.
در یکی از آزمایشها، مجموعهای متنوع از منابع خبری را در اختیار ۵۰ انسان و شش LLM قرار داده شد و از آنها خواسته اعتبار هر منبع را ارزیابی کنند و دلیل ارزیابی خود را توضیح دهند. پژوهشهای پیشین نشان میدهند که وقتی یک فرد با یک تیتر خبری مشکوک مواجه میشود، معمولاً چند اتفاق رخ میدهد.
- نخست، فرد تیتر را با دانستههای قبلی خود درباره جهان مقایسه میکند تا ببیند آیا با واقعیتهای پایه، رویدادهای گذشته یا تجربه شخصی او سازگار است یا خیر.
- دوم، خواننده انتظاراتی درباره منبع خبر را وارد فرایند قضاوت میکند؛ برای مثال اینکه آیا این منبع سابقه گزارشگری دقیق دارد یا به اغراق و سوگیری شناخته میشود.
- سوم، فرد بررسی میکند که آیا ادعا در قالب زنجیره گستردهتری از رویدادها منطقی به نظر میرسد، آیا وقوع آن از نظر واقعگرایانه ممکن بوده و آیا با نحوه وقوع معمول موقعیتهای مشابه همخوانی دارد یا خیر.
LLMها قادر به انجام این مراحل نیستند. تیم برای اینکه ببیند آنها در عوض چه کاری انجام میدهند، از مدلهای پیشرو خواست با پیروی از یک فرایند مشخص، میزان قابلیت اعتماد تیترهای خبری را ارزیابی کنند. به LLMها دستور داده شد معیارهایی را که برای تعیین اعتبار به کار میبرند بیان کنند و قضاوت نهایی خود را توجیه کنند. مشاهده شد که حتی زمانی که مدلها به نتایجی مشابه نتایج شرکتکنندگان انسانی میرسیدند، توجیهات آنها غالباً بازتابدهنده الگوهای استخراجشده از زبان بود؛ برای مثال اینکه ترکیب خاصی از واژهها با چه فراوانی در کنار یکدیگر ظاهر شدهاند و در چه بافتهایی به کار رفتهاند. در مقابل، این توجیهات به واقعیتهای بیرونی، رویدادهای پیشین یا تجربه؛ یعنی همان عواملی که انسانها در نظر میگرفتند ارجاع نمیدادند.
در آزمایشهای دیگری، استدلال انسانها و LLMها در مواجهه با دوراهیهای اخلاقی با یکدیگر مقایسه شد. وقتی انسانها درباره اخلاق فکر میکنند، به هنجارها، انتظارات اجتماعی، واکنشهای عاطفی و شهودهایی درباره آسیب و انصاف که تحتتأثیر فرهنگ شکل گرفتهاند، تکیه میکنند. برای نمونه، افراد هنگام ارزیابی اخلاقی اغلب از استدلال علّی استفاده میکنند:
- بررسی میکنند که یک رویداد چگونه به رویدادی دیگر منجر میشود
- چرا زمانبندی اهمیت دارد؟
- اگر چیزی در طول مسیر تغییر میکرد، اوضاع چگونه میتوانست به شکل دیگری پیش برود.
انسانها موقعیتهای متفاوت را از طریق تفکر خلافواقع تصور میکنند و از خود میپرسند: «اگر این شرایط متفاوت بود، چه اتفاقی میافتاد؟»
تیم پژوهشی دریافت که یک مدل زبانی میتواند این شکل از تأمل و سنجش را نسبتاً خوب بازتولید کند. مدل جملاتی ارائه میدهد که واژگان مرتبط با مراقبت، وظیفه یا حقوق را بازتاب میدهند. همچنین زبان علّی مبتنی بر الگوهای موجود در زبان، از جمله گزارههای خلافواقع «اگر-آنگاه»، تولید میکند. اما نکته مهم این است که مدل در واقع چیزی را تصور نمیکند و وارد هیچ فرایند تأملی نمیشود؛ بلکه صرفاً الگوهایی که در گفتار یا نوشتار انسانها درباره این موقعیتهای خلافواقع وجود دارند را بازتولید میکند. نتیجه ممکن است شبیه استدلال علّی به نظر برسد، اما فرایند پشت آن، تکمیل الگو است، نه درک اینکه رویدادها در جهان چگونه پیامدهایی ایجاد میکنند.
در تمام وظایفی که این تیم بررسی کرده، الگویی ثابت پدیدار میشود. LLMها اغلب میتوانند پاسخهایی مشابه پاسخهای انسان تولید کنند، اما به دلایلی که هیچ شباهتی به استدلال انسانی ندارند؛ بهطوری که:
- جایی که انسان قضاوت میکند، مدل همبستگی برقرار میکند.
- جایی که انسان ارزیابی میکند، مدل پیشبینی میکند.
- جایی که انسان با جهان تعامل دارد، مدل با یک توزیع از واژهها تعامل میکند.
معماری این مدلها آنها را در بازتولید الگوهای موجود در متن فوقالعاده توانمند میکند. اما این معماری به آنها دسترسی به جهانی که این واژهها به آن اشاره میکنند را نمیدهد. بااینحال، ازآنجاکه قضاوتهای انسانی نیز از طریق زبان بیان میشوند، پاسخهای مدل اغلب در سطح ظاهری شبیه پاسخهای انسان به نظر میرسند. این شکاف میان کاری که مدلها به نظر میرسد انجام میدهند و کاری که واقعاً انجام میدهند، همان چیزی است که این تیم پژوهشی آن را «اپیستمیا» (Epistemia) مینامد؛ وضعیتی که در آن شبیهسازی دانش، از دید ناظر، از خودِ دانش قابلتشخیص نیست. اپیستمیا نوعی خطا در تفسیر انسان از این مدلهاست که در آن، مقبولیت زبانی بهعنوان جایگزینی برای حقیقت در نظر گرفته میشود. این خطا از آنجا ناشی میشود که مدل روان و سلیس صحبت میکند و خوانندگان انسانی نیز به طور طبیعی آمادگی دارند که به سلاست بیان اعتماد کنند.
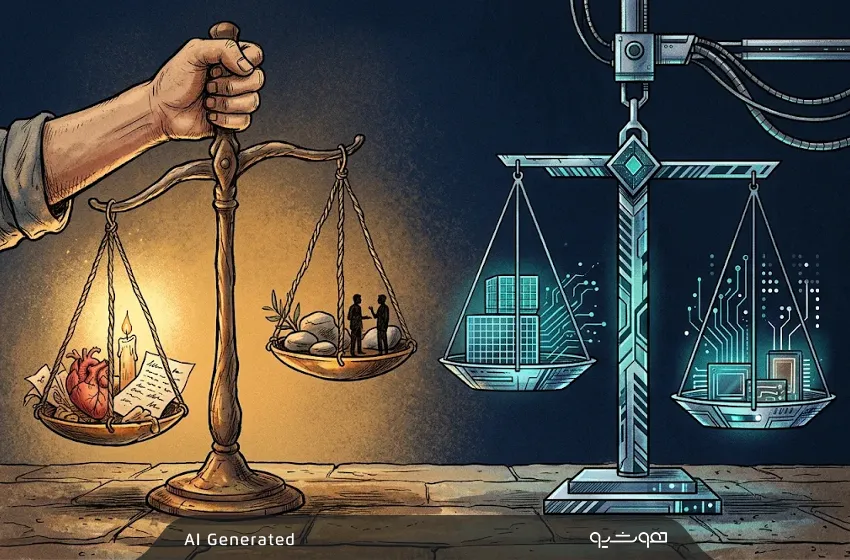
مسئله اصلی این نیست که مدلها اغلب اشتباه میکنند؛ انسانها نیز ممکن است اشتباه کنند. مسئله عمیقتر این است که مدل نمیتواند تشخیص دهد چه زمانی در حال «توهمزایی» است، زیرا اساساً قادر به بازنمایی حقیقت نیست. مدل نمیتواند باورهایی را شکل دهد، آنها را اصلاح کند یا خروجی خود را با جهان مقایسه و راستیآزمایی کند. همچنین نمیتواند یک ادعای قابلاعتماد را از ادعایی غیرقابلاعتماد تشخیص دهد، مگر از طریق قیاس با الگوهای زبانی پیشین. به بیان کوتاه، مدل نمیتواند کاری را انجام دهد که اساساً هدف قضاوت است.
انسانها همین حالا نیز از این سیستمها در موقعیتهایی استفاده میکنند که در آن تشخیص تفاوت میان مقبولیت و حقیقت ضروری است؛ از جمله حقوق، پزشکی و روانشناسی. یک مدل میتواند پاراگرافی تولید کند که شبیه تشخیص پزشکی، تحلیل حقوقی یا استدلال اخلاقی به نظر برسد؛ اما صدا و ظاهر، جایگزین محتوا نیست. شبیهسازی، همان چیزی نیست که شبیهسازی شده است.
هیچیک از این موارد به این معنا نیست که باید LLMها را کنار گذاشت. این مدلها زمانی که بهعنوان چیزی که واقعاً هستند مورداستفاده قرار گیرند؛ ابزارهایی فوقالعاده قدرتمند و موتورهای خودکارسازی زبانی، نه موتورهای فهم و درک. آنها در نوشتن پیشنویس، خلاصهسازی، ترکیب مجدد و کاوش ایدهها عملکردی عالی دارند؛ اما زمانی که از آنها میخواهیم قضاوت کنند، ناخواسته معنای قضاوت را بازتعریف میکنیم و آن را از رابطه میان یک ذهن و جهان، به رابطه میان یک پرامپت و یک توزیع احتمالاتی واژگان تغییر میدهیم.
خواننده باید با دانستن این موضوع چه کند؟
از این سیستمها نترسید؛ در عوض، به دنبال درک روشنتری از تواناییها و محدودیتهای آنها باشید. به خاطر داشته باشید که روانبودن و سلاست بیان، بینش نیست و فصاحت، نشانه درک و فهم نیست. با مدلهای زبانی بزرگ مانند ابزارهای زبانی پیشرفتهای برخورد کنید که دقیقاً به دلیل نداشتن دسترسی به حوزهای که قضاوت در نهایت به آن وابسته است؛ یعنی خودِ جهان به نظارت انسانی نیاز دارند.
گزارش حاضر در نسخه May 2026 نشریه Scientific American منتشر شده است.