آنتروپیک توضیح میدهد:
آموزش هوش مصنوعی برای ساخت مدلهای علمی
سید محمدجواد فیاض
- ۲۵ آبان ۱۴۰۵
آنتروپیک با روایت یک واقعه علمی واقعی، روند آموزش مدلهای هوش مصنوعی برای ساخت یک مدل هوش مصنوعی برای کارهای علمی را توضیح میدهد.
در سال ۱۹۵۱، رایانه دانشگاه کمبریج به مدت شش ماه از کار افتاد. این اتفاق برای «اندرو هاکسلی» (Andrew Huxley) فیزیولوژیست دردسرساز شد. او به همراه همکارش «آلن هاجکین» (Alan Hodgkin)، بهتازگی مجموعهای از معادلات را برای توصیف نحوه فعالیت الکتریکی یک سلول عصبی در نوعی ماهی مرکب طراحی کرده بود.
یک روایت واقعی
هدف هاکسلی و هاجکین درک «پتانسیل عمل» (Action Potential) بود؛ پالسهای الکتریکیای که سلولهای عصبی برای برقراری ارتباط از آنها استفاده میکنند و زیربنای عملکردهای مغز، از ادراک تا هوش هستند. برای بررسی اعتبار معادلات، دانشمندان باید آنها را حل میکردند و نتایج را با دادههای تجربی مقایسه میکردند. هاکسلی قصد داشت از رایانه جدید دانشگاه برای حل معادلات استفاده کند، اما با ازکارافتادن آن مجبور شد سراغ ماشینحساب مکانیکی دستی برود. این کار بیش از سه هفته زمان برد.
ساختار اصلی مدل آنها بر اساس اطلاعات شناختهشده درباره سلول طراحی شده بود. هاجکین و هاکسلی غشای سلول را بهصورت یک مدار الکتریکی مدلسازی کردند. بااینحال، یکی از اجزای مدل بر پایه حدس علمی شکل گرفت. آنها برای اینکه منحنی مدل با دادههای اندازهگیریشده مطابقت پیدا کند، مجبور شدند یکی از متغیرها را به توان چهار برسانند. در آن زمان، دلیل این ضرورت را نمیدانستند؛ فقط مشاهده کرده بودند که بدون این تغییر، مدل نمیتواند دادههای تجربی را بهخوبی پیشبینی کند. بااینحال، فرضیهای محتاطانه مطرح کردند: شاید توان چهارم به این دلیل ضروری باشد که پیش از باز شدن کانالهای خاصی در غشای سلول، چهار ذره باردار باید در موقعیت مناسب قرار بگیرند.
چند دهه بعد، پژوهشگران ساختار یک پروتئین کانال پتاسیمی مرتبط را کشف کردند. این پروتئین از چهار بخش یکسان تشکیل شده بود که پیرامون یک منفذ مرکزی قرار داشتند. بهاینترتیب، فرضیه اولیه هاجکین و هاکسلی تا حد زیادی تأیید شد. مدل آنها که در سال ۱۹۵۱ برای تطبیق با دادههای تجربی ساخته شده بود، نهتنها سرعت انتشار پیام عصبی را با دقت مناسبی پیشبینی میکرد، بلکه به پیشبینی ساختار کانالهای یونی پتاسیم نیز کمک کرده بود؛ ساختاری که اساساً برای تطبیق با آن طراحی نشده بود.
وجه تمایز
امروزه یک سامانه هوش مصنوعی احتمالاً میتواند معادلاتی مشابه مدل هاجکین و هاکسلی را در چند ساعت پیدا کند و حتی تطبیق دقیقتری با دادههای تجربی ارائه دهد. اما نکته اصلی این است که صرفاً یافتن معادلهای که دادهها را بازتولید میکند، به معنای دستیابی به درک علمی نیست. اهمیت کار هاجکین و هاکسلی در این بود که آنها میدانستند نسخههای سادهتر مدل کارایی لازم را ندارند. بازتولید دادهها بهتنهایی کافی نیست؛ زیرا مدلهای متعددی ممکن است نتایج مشابهی تولید کنند. آنچه اهمیت دارد، استخراج ادعاهایی درباره خود پدیده واقعی و ترجیحاً پدیدههای مشابه است. برای رسیدن به این هدف باید مشخص شود مدل چه ویژگیهایی با مدلهای معتبر دیگر مشترک دارد و چه تفاوتهایی آن را از مدلهای ناموفق متمایز میکند.
سه مرحله اصلی مدلسازی علمی
مدل هاجکین و هاکسلی با گذشت بیش از ۷۰ سال، همچنان توصیف استانداردی از فعالیت الکتریکی نورونها ارائه میدهد. معادلات مشابهی با ثابتهای متفاوت، فعالیت سلولهای عصبی گونههای مختلف جانوری، از ماهی مرکب تا انسان را توصیف میکنند.
این مدل همچنین نشان میدهد فرایند مدلسازی علمی از سه مرحله اصلی تشکیل شده است:
- ساخت مدل (Building): تعیین اجزای مدل و ساختار معادلات آن.
- مقیدسازی مدل (Constraining): تنظیم پارامترهای قابلتغییر مدل برای تطبیق با اندازهگیریهای واقعی.
- تفسیر مدل (Interpreting): بررسی اینکه مدل درباره سامانه واقعی چه اطلاعاتی ارائه میکند.
دانشمندان معمولاً این مراحل را بهصورت تکرارشونده انجام میدهند. اگر خروجی مدل با اندازهگیریها مطابقت نداشته باشد یا تفسیر آن منطقی به نظر نرسد، به مراحل قبلی بازمیگردند و مدل را اصلاح میکنند. هوش مصنوعی بهتدریج در هر سه مرحله نقش پیدا کرده است؛ بااینحال، بیشترین پیشرفت آن تاکنون در مقیدسازی مدلها اتفاق افتاده است.
مقیدسازی مدلها؛ فراتر از یافتن بهترین مجموعه پارامترها
هاجکین و هاکسلی پارامترهای مدل خود را با مشاهده دادهها و استفاده از شهود علمی تنظیم کردند و در نهایت به یک مجموعه مشخص از اعداد رسیدند. این مجموعه نشان میداد که مدل میتواند دادههای تجربی را بازتولید کند، اما مشخص نمیکرد آیا مجموعههای دیگری از پارامترها نیز میتوانند همان نتیجه را ایجاد کنند یا حتی عملکرد بهتری داشته باشند.
برای درک این مسئله میتوان یک صورتحساب ۱۲۰ دلاری در یک رستوران را در نظر گرفت. اگر فقط مبلغ نهایی مشخص باشد، ترکیبهای مختلفی از سفارشها میتوانند به این مبلغ منتهی شده باشند. ممکن است همه افراد یک غذای متوسط سفارش داده باشند یا یک نفر غذای گرانقیمتی خورده باشد و دیگران سفارشهای ارزانتری داشته باشند.
در مدلهای علمی نیز وضعیت مشابهی وجود دارد. ترکیبهای متفاوتی از پارامترها ممکن است خروجی تقریباً یکسانی تولید کنند. بنابراین، ارائه تنها یک مجموعه پارامتر که با دادهها تطبیق دارد، سایر توضیحات محتمل را پنهان میکند؛ درحالیکه برخی از این ترکیبهای جایگزین ممکن است پیشبینیهای متفاوتی داشته باشند.
یکی از روشهای مقابله با این مسئله، «استنتاج بیزی» (Bayesian Inference) است. این روش بهجای ارائه یک مجموعه پارامتر، توزیعی احتمالاتی از مجموعههایی ارائه میدهد که میتوانند دادههای مشاهدهشده را توضیح دهند. این توزیع، علاوه بر میزان تطبیق هر مجموعه پارامتر با دادهها، دانش و اطلاعات پیشین درباره پارامترها را نیز در نظر میگیرد. مجموعههایی که تطبیق بهتری دارند، احتمال بیشتری دریافت میکنند. بااینحال، اجرای استنتاج بیزی استاندارد برای مدلهای پیچیده معمولاً از نظر محاسباتی دشوار یا غیرممکن است؛ زیرا باید احتمال مشاهده دادهها را برای تمام ترکیبهای ممکن پارامترها محاسبه کرد.
روش دیگری به نام «استنتاج مبتنی بر شبیهسازی» (Simulation-Based Inference) یا (SBI) این محدودیت را برطرف میکند. در این روش، ابتدا پارامترهای مختلف بهصورت تصادفی انتخاب میشوند، سپس مدل با هر مجموعه پارامتر اجرا و خروجی آن ثبت میشود. این فرایند ممکن است برای مدلی مانند هاجکین و هاکسلی حدود ۱۰۰ هزار بار و برای مدلهای پیچیدهتر میلیونها بار تکرار شود. سپس یک شبکه عصبی با استفاده از نتایج این شبیهسازیها آموزش میبیند تا بتواند با دریافت یک خروجی مشخص، محدوده پارامترهایی را که احتمالاً آن خروجی را تولید کردهاند، تخمین بزند.
مزیت اصلی SBI این است که برای اجرا به محاسبه مستقیم احتمال دادهها نیاز ندارد. کافی است مدل قابلیت اجرا داشته باشد؛ یعنی با دریافت پارامترها، دادههای خروجی تولید کند. به چنین مدلی «شبیهساز» (Simulator) گفته میشود. شبیهسازها میتوانند برنامههای رایانهای یا حتی مجموعهای از قواعد باشند که اجرای آنها ساده است، اما معکوسسازی فرایند تولید خروجی در آنها دشوار یا غیرممکن است. بسیاری از پدیدههای پیچیده، از شبکههای نورونی تا برخورد کهکشانها اساساً با چنین مدلهایی بررسی میشوند.
اجرای تعداد زیادی شبیهسازی هزینه محاسباتی بالایی دارد و ممکن است هفتهها طول بکشد؛ اما پس از آموزش شبکه عصبی، استنباط درباره دادههای جدید میتواند در چند ثانیه انجام شود. این قابلیت کاربردهای مهمی پیدا کرده است. ازآنجاییکه SBI بهجای یک پاسخ منفرد، توزیعی از پارامترهای محتمل ارائه میکند، پژوهشگران میتوانند تشخیص دهند کدام پارامترها بهخوبی بهوسیله دادهها مقید شدهاند، در کدام بخشها چند توضیح متفاوت همچنان محتمل است و برای رفع ابهام به چه اندازه داده یا آزمایش بیشتر نیاز دارند.
ساخت مدلها با کمک عاملهای هوش مصنوعی
پیش از مقیدسازی، باید مدلی وجود داشته باشد. معادلات هاجکین و هاکسلی از اصول اولیه فیزیک و زیستشناسی استخراج نشده بودند، بلکه بر اساس دانش زیستی، مشاهده تجربی و آزمودن ساختارهای مختلف شکل گرفتند. در بیشتر تاریخ علم، ساخت مدل به تخصص و قضاوت پژوهشگران وابسته بوده است. دانشمندان یک مدل پیشنهادی طراحی میکردند، آن را با دادهها میسنجیدند و در صورت نیاز اصلاح میکردند. مشکل این رویکرد آن است که فضای مدلهای ممکن تقریباً نامحدود است و پژوهشگری که فقط چند مدل را بر اساس تجربه خود پیشنهاد میدهد، احتمالاً بسیاری از مدلهای معتبر دیگر را بررسی نخواهد کرد.
اکنون عاملهای مبتنی بر مدلهای زبانی بزرگ (LLM-based Agents) میتوانند در این مرحله نیز مشارکت کنند. این سامانهها با دریافت دادهها و توصیفی به زبان طبیعی از یک سامانه، کد یک یا چند مدل پیشنهادی را تولید میکنند. سپس مدلها را اجرا میکنند، پارامترهای آنها را مقید میکنند، خروجی را با دادههای واقعی مقایسه میکنند و در صورت نیاز، ساختار معادلات را تغییر میدهند. این چرخه تا زمانی ادامه مییابد که مدل بتواند دادهها را با دقت کافی بازتولید کند.
چندین سامانه از این نوع طی دو سال گذشته معرفی شدهاند. ویژگی مشترک آنها استفاده از LLM برای طراحی خود مدل است؛ کاری که تا همین اواخر عموماً در انحصار پژوهشگران انسانی تصور میشد. بااینحال، ارائه یک مدل منطبق با دادهها به معنای دستیابی به بینش علمی نیست. همانطور که پارامترهای مختلف در یک مدل میتوانند خروجی مشابهی تولید کنند، مدلهای متفاوت با ساختار معادلات مختلف نیز ممکن است دادههای یکسانی را توضیح دهند. حتی اگر یک عامل هوش مصنوعی دو بار روی دادههای یکسان اجرا شود، ممکن است دو مدل متفاوت اما به یک اندازه معتبر ارائه کند.
راهکار پیشنهادی آنتروپیک این است که ساخت مدل نیز مانند مقیدسازی آن انجام شود؛ یعنی بهجای جستوجوی یک مدل بهینه، مجموعهای از مدلهای محتمل بررسی شوند. در این رویکرد، هوش مصنوعی مدلهای متعددی پیشنهاد میکند و هر مدل بر اساس میزان پشتیبانی دادهها ارزیابی میشود. مدلهایی که برای تطبیق با دادهها به انعطافپذیری و پیچیدگی زیادی نیاز دارند، امتیاز کمتری دریافت میکنند. سپس مدلهای ضعیف کنار گذاشته میشوند و نسخههای جدیدی از مدلهای قویتر تولید میشوند.
خروجی این فرایند، توزیعی از مدلهای محتمل است. اگر همه مدلهای باقیمانده ویژگی مشترکی داشته باشند، میتوان نتیجه گرفت که دادهها از آن ویژگی پشتیبانی میکنند. اما اگر مدلها با یکدیگر اختلاف داشته باشند، این اختلاف نشاندهنده محدودیت شواهد موجود و فرصتی برای طراحی آزمایشهای جدید است. البته آنتروپیک تأکید میکنند که این سامانهها تاکنون عمدتاً برای کشف مجدد مدلهایی آزمایش شدهاند که دانشمندان از قبل آنها را میشناختند. شواهد درباره عملکردشان در مسائلی که پاسخ شناختهشدهای ندارند، همچنان محدود است.
تفسیر مدلها؛ دشوارترین مرحله برای هوش مصنوعی
پس از ساخت و مقیدسازی مدل، باید مشخص شود که خروجی آن چه چیزی درباره سامانه واقعی به ما میگوید. فرضیه چهار ذره در مدل هاجکین و هاکسلی برایناساس شکل گرفت که وجود توان چهارم در معادله میتوانست نشاندهنده ضرورت وقوع چهار فرایند مستقل برای باز شدن یک کانال باشد. اما اهمیت این تفسیر به آن دلیل بود که مدلهای سادهتر، مانند مدلهای مبتنی بر توانهای پایینتر، عملکرد مشابهی نداشتند. در واقع، ردشدن توضیحات جایگزین بود که به فرضیه آنها اعتبار میبخشید.
البته تعداد دقیق اجزای متحرک کاملاً قطعی نبود. هاجکین و هاکسلی اشاره کرده بودند که توان سوم یا چهارم برای توضیح دادهها لازم است و در نهایت توان چهارم را انتخاب کردند. آنها حتی احتمال میدادند توانهای بالاتر اندکی بهتر عمل کنند، اما بهبود احتمالی را ارزشمندتر از پیچیدگی اضافی مدل نمیدانستند. معادلات آنها پیامدهای دیگری نیز داشتند؛ از جمله توضیح آستانه ولتاژی نورونها، شکل تقریباً یکسان پالسهای عصبی و این پیشبینی که افزایش جریان الکتریکی با سرعت بسیار کم ممکن است هرگز به فعالشدن سلول عصبی منجر نشود.
در فلسفه علم، نظریهای «قابلفهم» (Intelligible) محسوب میشود که بتوان پیامدهای آن را بدون نیاز به اجرای مکرر مدل استنتاج کرد. این کار برای مدلهای کوچک با چند متغیر امکانپذیر است، اما در مدلهایی با هزاران متغیر، دستیابی به چنین درکی دشوارتر میشود. در این شرایط، شاید بتوان مدل را به چند سازوکار اصلی تقلیل داد که بازسازی آن را ممکن میکنند.
تفسیر مدلها، دشوارترین بخش برای واگذاری به هوش مصنوعی در میان سه مرحله مدلسازی است؛ زیرا برخلاف میزان تطبیق مدل با دادهها، سنجش میزان درکی که مدل از سامانه واقعی ایجاد میکند، معیار مشخص و سادهای ندارد. دو رویکرد برای ارزیابی این مسئله پیشنهاد شده است. رویکرد نخست، سنجش توانایی مدل در پیشبینی رفتار سامانه هنگام ایجاد اختلال در آن است. رویکرد دوم، بررسی این موضوع است که آیا خروجی عامل هوش مصنوعی به دانشمندان انسانی در درک بهتر مسئله کمک میکند یا خیر.
بهعنوانمثال، یک سامانه هوش مصنوعی برای طراحی آزمایشهای کوانتومی بهجای ارائه تنها یک چیدمان آزمایشی، برنامهای کوتاه تولید میکند که مجموعهای از آزمایشهای مرتبط را ایجاد میکند. در نتیجه، فیزیکدان میتواند اصل طراحی مشترک این آزمایشها را مستقیماً از روی برنامه استخراج کند، نه اینکه مجبور باشد آن را از یک آزمایش منفرد استنباط کند.
در این مرحله نیز دسترسی به مجموعهای از مدلهای محتمل اهمیت اساسی دارد. یک مدل منفرد مشخص نمیکند کدام بخشهای آن واقعاً بهوسیله دادهها تأیید شدهاند و کدام بخشها همچنان نامطمئن هستند. همچنین، مقایسه پیشبینیهای مدلهای مختلف درباره رفتار سامانه پس از ایجاد اختلال میتواند اعتبار نتایج را مشخص کند. اگر همه مدلهای سازگار با دادهها پیشبینی یکسانی داشته باشند، اطمینان به آن پیشبینی بیشتر است؛ اما اختلاف میان مدلها میتواند مسیر آزمایش بعدی را مشخص کند.
از مدلسازی یک سلول تا شبیهسازی کل مغز
بسیاری از مدلهای مشهور علمی، از جمله مدل هاجکین و هاکسلی، ساختاری فشرده دارند. این مدلها شامل تعداد محدودی متغیر و معادله هستند و دانشمندان میتوانند آنها را بنویسند، اجرا کنند و پیامدهایشان را درک کنند. اما با افزایش توانایی هوش مصنوعی در ساخت و مقیدسازی مدلها، این محدودیت بهتدریج کاهش مییابد.
یکی از مهمترین حوزههای کاربردی، علوم اعصاب است. معادلات هاجکین و هاکسلی فعالیت یک سلول عصبی را توصیف میکنند؛ درحالیکه مغز مگس میوه بیش از ۱۰۰ هزار نورون و مغز انسان دهها میلیارد نورون دارد. رفتار و تفکر نیز حاصل تعامل میان این نورونهاست.
اکنون پژوهشگران به نقشهای کامل از اتصالات مغز مگس میوه دسترسی دارند که نورونها و ارتباطات میان آنها را نشان میدهد. بر اساس این نقشه، مدلهای بزرگمقیاسی ساخته شدهاند که از جمله میتوانند فعالیت نورونها در سراسر سامانه بینایی مگس را پیشبینی کنند.
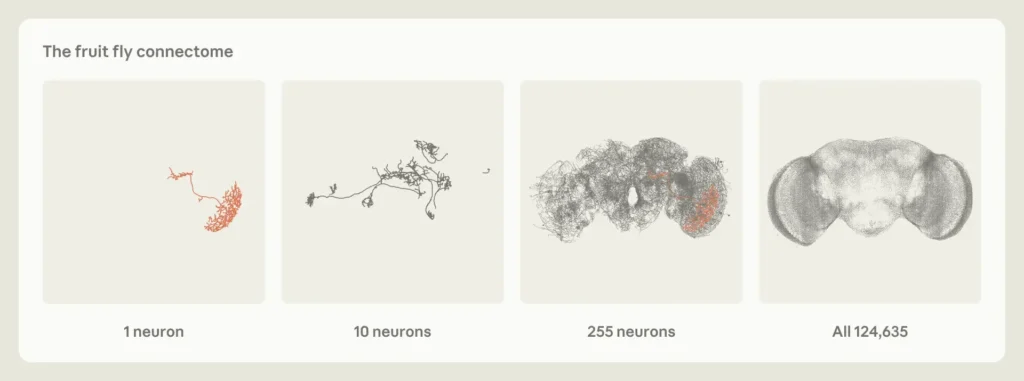
این پیشرفت امکان طرح پرسشهایی را فراهم کرده است که پیشتر بررسی آنها عملی نبود: مغز چگونه از طریق ساختار اتصالات خود به رفتار منجر میشود؟ چه میزان از رفتار یک جانور را میتوان صرفاً بر اساس نقشه اتصالات مغزی پیشبینی کرد؟ و کدام اتصالات واقعاً اهمیت دارند؟ در چنین مقیاسی، احتمالاً نمیتوان به یک مدل صحیح و نهایی دست یافت. در واقع، دادههای علمی معمولاً با چندین مدل سازگارند. همانطور که «جورج باکس»، آماردان، گفته است: «همه مدلها نادرستاند، اما برخی از آنها مفیدند.»
بنابراین، پرسش اصلی دیگر این نیست که کدام مدل درست است، بلکه این است که چه ویژگیهایی در تمام مدلهای سازگار با دادهها مشترکاند و چه پیشبینیهایی میتوان از آنها استخراج کرد. در این رویکرد، ارزشمندترین آزمایشها آنهایی هستند که بتوانند بیشترین تعداد از مدلهای باقیمانده را رد کنند.
این شیوه محدود به علوم اعصاب نیست. دانشمندان اقلیمشناسی نیز از شبیهسازیهای عددی عظیمی استفاده میکنند که هرکدام بر اساس فرضیات متفاوتی ساخته شدهاند و پیشبینیهای نهایی را بهصورت دامنهای از نتایج ارائه میکنند. فیزیکدانان ذرات در برخورددهنده بزرگ هادرونی نیز هنگام جستوجوی ذرات جدید، بهجای تأیید یا رد یک نظریه واحد، مشخص میکنند کدام نسخههای آن با دادههای تجربی سازگارند و کدام نسخهها رد شدهاند.
ارزش علمی در فرایند ساخت مدل است
کار زمانبر هاجکین و هاکسلی صرفاً تلاشی برای رسیدن به یک مجموعه معادله نبود. آنها مدل را ساختند، پارامترهای مختلف را آزمودند، نسخههای ناموفق را کنار گذاشتند و در نهایت توانستند درباره سازوکار واقعی سلول عصبی فرضیهپردازی کنند. درک آنها از مدل، حاصل مشارکت مستقیم در فرایند ساخت و اصلاح آن بود؛ فرایندی که در نهایت به بخشی از کشفیات برنده جایزه نوبل آنها تبدیل شد.
هوش مصنوعی اکنون میتواند بخش بزرگی از این کار را در چند ساعت انجام دهد. اما برای اینکه خروجی آن به درک علمی منجر شود، نباید صرفاً مدل نهایی را ارائه کند. سامانه باید مشخص کند کدام بخشهای مدل بهوسیله دادهها پشتیبانی میشوند، چه بخشهایی همچنان نامطمئناند، کدام گزینههای جایگزین در طول فرایند رد شدهاند و چه پرسشهای تازهای از این مسیر به وجود آمدهاند.
یک مدل علمی ممکن است پاسخی ارائه کند، اما بینش علمی در فرایند ساخت و بررسی آن شکل میگیرد.