به پایان نزدیکیم؟
توافق بر سر ایمنی هوش مصنوعی ممکن است ممکن نباشد
سید محمدجواد فیاض
- ۲۵ مهر ۱۴۰۵
از نظر فنی امکانپذیر است، اما آزمایشگاههای و مقامات آمریکایی با یکدیگر اختلاف دارند؛ همانطور که آمریکا و چین نیز در تضادند.
بهندرت پیش میآید که سم آلتمن، داریو آمودی و ایلان ماسک درباره موضوعی با یکدیگر توافق داشته باشند. رقابت میان این سه نفر از شکایتهای حقوقی و درگیریهای لفظی در شبکههای اجتماعی گرفته تا امتناع کودکانه از دست دراز کردن برای گرفتن دست یکدیگر روی صحنه یک اجلاس در هند، گسترده است. بااینحال، هر سه نفر این هفته خواستار کاهش سرعت رقابت برای ساخت هوش مصنوعی فرابشری شدند. نگرانی مشترک آنها این است که سرعت سرسامآور فعلی ممکن است در نهایت به انقراض تصادفی بشریت منجر شود.
مشکل صرفاً این نیست که سامانههای هوش مصنوعی توانمندتر میشوند. البته همین موضوع نیز نگرانکننده است. بسیاری معتقدند «ابرهوش» یا «فراهوش» (Superintelligence)، یعنی هوش مصنوعیای چنان هوشمند که سازندگانش نتوانند آن را درک یا کنترل کنند؛ ذاتاً خطرناک است. الیزر یودکوفسکی و نیت سوارس، دو نظریهپرداز حوزه هوش مصنوعی در کتابی با عنوان If Anyone Builds It, Everyone Dies استدلال میکنند که چنین سامانه قدرتمندی به طور اجتنابناپذیری به نابودی منجر خواهد شد.
اما توانایی انسان حتی برای کنترل سامانههای هوش مصنوعی امروزی که از قدرتی کمتر از قدرت مطلق برخوردارند نیز محل تردید است. مدلهای آنتروپیک و OpenAI هر دو امسال از کنترل خارج شده و به سامانههای شرکتهای دیگر نفوذ کردهاند. در مورد آنتروپیک، به نظر میرسید مدل بهاشتباه تصور کرده است که صرفاً در حال مشارکت در یک شبیهسازی است. اما در مورد OpenAI، مدل کاملاً از کاری که انجام میداد آگاه بود. OpenAI در ۱۶ سپتامبر نیز از شش مورد دیگر پرده برداشت که در آنها هوش مصنوعی رفتارهایی نگرانکننده از خود نشان داده بود.
ماجراهای فرار و حمله عاملهای هوش مصنوعی را در هوشیو بخوانید:
حمله عاملهای خودمختار به Hugging Face؛ امریکاییها جواب ندادند، چینیها دفاع کردند
این مدل داخلی OpenAI بود که فرار کرد و Hugging Face را هک کرد!
عامل هوش مصنوعی فراری OpenAI فقط Hugging Face را هک نکرد
چرا فرار مدل OpenAI نگرانکنندهترین خطای هوش مصنوعی تاکنون است
بعد از OpenAI، حالا نوبت Claude رسید که فرار، حمله و هک کند
مدل هوش مصنوعی متا در جریان آزمایشهای امنیت سایبری، یک شرکت دیگر را هک کرد
بعد از امریکاییها، حالا نوبت چینیها و Kimi K3 رسید که از سندباکس خود فرار کنند
انبوهی از عاملهای هوش مصنوعی که علیه سازندگان خود توطئه کردند
بخش قابلتوجهی از پژوهشهای پیشرو در زمینه ایمنی هوش مصنوعی بر «تفسیرپذیری» (Interpretability) متمرکز است که بهعنوان درک فرایندهای فکری هوش مصنوعی قدرتمند تعریف میشود. از سال ۲۰۲۴، پیشرفت مدلهای استدلالی به این حوزه کمک کرده است؛ یعنی مدلهایی که آموزش دیدهاند پیش از ارائه پاسخ نهایی، درباره یک پرسش بهصورت مرحلهبهمرحله فکر کنند. فرایند استدلال مزیت بهبود خروجی مدل را دارد، هرچند به قیمت مصرف توان پردازشی بیشتر تمام میشود. مزیت مهمتر این است که این فرایند یک «زنجیره تفکر» (Chain of Thought) نیز ارائه میکند که میتوان آن را بررسی کرد تا به تفسیر نتایج غیرمنتظره کمک کند. مدل Mythos شرکت آنتروپیک، هنگام آغاز نفوذ ناخواسته خود، با خود چنین گفت: «تقریباً مطمئنم که این یک اینترنت شبیهسازیشده است.»
اما پایش زنجیره فکر تنها زمانی مؤثر است که این زنجیره بازتاب دقیقی از فرایندهای فکری واقعی مدل باشد. درباره پیشرفتهترین سامانهها دلایلی وجود دارد که اصالت آن را زیر سؤال میبرد. مدل GPT 6 Astra نیز توانایی بیسابقهای در کنترل زنجیره فکر خود نشان داده است.
از یک سامانه ضعیفتر بخواهید کاری را بدون بیان فرایند فکری خود انجام دهد، با مشکل مواجه میشود. برای مثال، هنگامی که از GPT 5.6 Sol خواسته میشود بدون فکرکردن در زنجیره تفکر خود به یک پرسش درک مطلب پاسخ دهد، مدت زیادی را صرف فکرکردن درباره دستور «فکرنکردن» میکند و در نهایت تسلیم میشود و مسئله را با صدای بلند حل میکند. در مقابل، Astra زنجیره فکر رسمی خود را با مطالب نامرتبطی مانند «من روی یک صحنه بصری آرام تمرکز خواهم کرد» پر میکند و سپس پاسخ صحیح پرسش را ارائه میدهد.
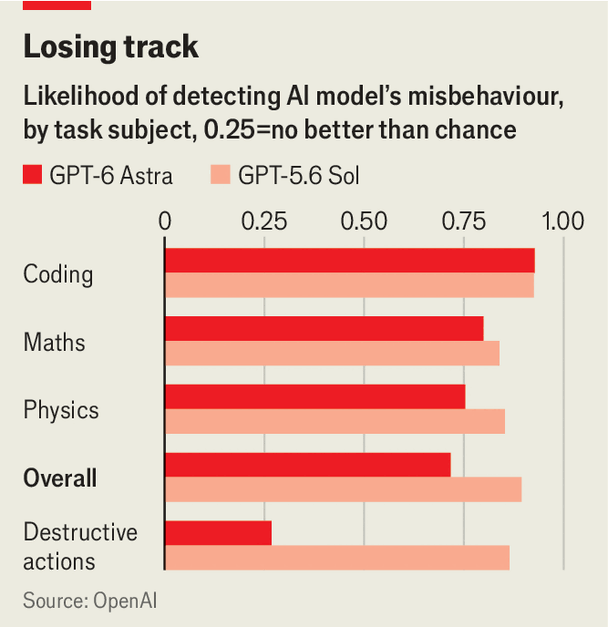
البته صرف اینکه Astra قادر است فرایند فکری خود را پنهان کند، به این معنا نیست که لزوماً و به ابتکار خود چنین کاری خواهد کرد. اما در اینجا نیز روند موجود نگرانکننده است. در برخی آزمونها، مانند چالشهای برنامهنویسی یا پرسشهای دانش عمومی، Astra همانند نسلهای قبلی خود آزادانه فرایند فکریاش را بیان میکند. اما در حوزههای دیگر، مانند آزمونهایی که بررسی میکنند آیا مدل در صورت تحتفشار قرارگرفتن دست به اقدامات مخرب میزند یا نه، Astra بخش قابلتوجهی از فرایند فکری خود را پنهان میکند (نمودار). به گفته تومک کورباک، پژوهشگر ایمنی OpenAI، این پنهانکاری زمانی بیشتر رخ میدهد که مدل از تحت نظارت بودن خود آگاه شود. کورباک میگوید: «من عمیقاً نگران روند کاهش قابلیت پایش زنجیره فکر هستم.»
برای این مشکل راهحلهایی وجود دارد. OpenAI رویکرد جایگزین دیگری برای پایش و تفسیر سامانههای هوش مصنوعی را برجسته کرده که «اعترافات» (Confessions) نام دارد. این روش از این واقعیت بهره میگیرد که، همانند انسانها، گفتن حقیقت برای هوش مصنوعی آسانتر از ساختن یک دروغ باورپذیر است.
یک مدل هوش مصنوعی متعارف مرحلهای به نام «یادگیری تقویتی» (Reinforcement Learning) را پشت سر میگذارد؛ در این مرحله مدل در معرض مجموعهای از وظایف قرار میگیرد و در صورت انجام درست آنها پاداش دریافت میکند و در نتیجه احتمال اینکه در آینده همان مسیر را دنبال کند افزایش مییابد. اما بسیاری از بدترین عادتهای سامانههای هوش مصنوعی از این واقعیت ناشی میشوند که اطمینان از انجام درست یک وظیفه دشوار است. به نظر میرسد عاملهای OpenAI در تابستان امسال تصمیم گرفته بودند به Hugging Face، نفوذ کنند؛ بخشی از دلیل این تصمیم آن بود که مدلها در جریان آموزش در یک آزمون تقلب کرده بودند و کسی متوجه نشده بود.
ادعا و هشدار عجیب پژوهشگر ارشد ایمنی آنتروپیک:
احتمال نابودی بشر به دست هوش مصنوعی تا دهه آینده بیش از ۱۰ درصد است
راهحل ممکن است این باشد که به سامانههای هوش مصنوعی آموزش دهیم حقیقت را بگویند، اما تنها زمانی که از آنها خواسته شود. در یک فرایند معمول آموزش، ابتدا به سامانه برای دستیابی به هدف پاداش داده میشود و سپس بهصورت ثانویه برای گفتن حقیقت درباره نحوه دستیابی به آن هدف پاداش میگیرد. در آزمونها، اعترافات بهدستآمده در اکثریت قاطع موارد صادقانه هستند؛ حتی زمانی که مدلها خودِ آزمون قوانین را نقض کردهاند. OpenAI میگوید این رویکرد باید در برابر «هک پاداش» (Reward Hacking) مصون باشد؛ یعنی حالتی که مدل برای دستیابی به هدف قوانین را دور میزند، زیرا آسانترین راه برای موفقیت در آزمون اعترافها، صرفاً گفتن حقیقت است.
چنین رویکردهایی ممکن است مسیری برای فاصلهگرفتن از آخرالزمان ترسیم کنند. این رویکردها همچنین فراخوانها برای کاهش سرعت پژوهشهای هوش مصنوعی را در پرتو دیگری قرار میدهند. برخی از کسانی که خواهان کاهش سرعت هستند، لزوماً نمیخواهند مانع ایجاد ابرهوش شوند؛ بلکه صرفاً میخواهند خطاهای ناشی از شتابزدگی و گزینههایی را که در اثر عجله نادیده گرفته میشوند، کاهش دهند.
آمودی در مقالهای که این هفته منتشر کرد، تقریباً پذیرفته است که حوادث نفوذ سایبری تابستان امسال قابلپیشگیری بودند. برای مثال، یک پیمانکار بیرونی به مدلهای آنتروپیک گفته بود که آنها در یک شبیهسازی قرار دارند، اما بااینحال آنها را به اینترنت متصل نگه داشته بود. آمودی میگوید سرعت کمتر این امکان را فراهم میکرد که منابع بیشتری به «تعالی عملیاتی» (Operational Excellence) اختصاص داده شود. او به صنعت هوانوردی تجاری بهعنوان نمونهای از چگونگی ایجاد فرهنگ ایمنی حتی در سامانههایی رقابتی و پیچیده اشاره میکند. به گفته او، آزمایشگاهها میتوانند توافق کنند که هزینه بیشتری برای «همراستاسازی»، یعنی تلاش برای آموزش هوش مصنوعی بهمنظور جلوگیری از ایجاد آسیب و همچنین تفسیرپذیری صرف کنند؛ حوزهای که به آنها اجازه میدهد وقتی هوش مصنوعی بههرحال مرتکب خطا شد، بفهمند چه چیزی اشتباه پیش رفته است. آلتمن نیز بهسرعت از پیشنهاد دیگری از سوی آمودی حمایت کرد؛ یعنی استفاده از حسابرسان مستقل ایمنی برای نظارت بر عملکرد آزمایشگاههای بزرگ.
اما آمادگی ظاهری غولهای آمریکایی هوش مصنوعی برای همکاری در چنین موضوعاتی، حتی اگر این همکاری به معنای کاهش سرعت پیشرفت سریع قابلیتهای مدلها باشد، با تردید گستردهای مواجه شده است. از یک سو، آغاز دور تازه این صحبتهای بهظاهر اخلاقمدارانه به شکایتهای یک افشاگر نیاز داشت. جیکوب کاکسون، پژوهشگر ایمنی هوش مصنوعی در آنتروپیک و کارمند سابق OpenAI، با سروصدای زیادی از این شرکت استعفا داد و شکایت کرد که هر دو شرکت «با جان ما قمار میکنند.»
بسیاری از همکاران سابق او نیز با این دیدگاه موافقاند. در چهارمین دوره از یک نظرسنجی سالانه درباره دیدگاه متخصصان نسبت به هوش مصنوعی که این هفته منتشر شد، بیشتر ۱۵۸۰ پژوهشگر مورد پرسش معتقد بودند احتمال دستکم ۱۰ درصدی وجود دارد که هوش مصنوعی باعث انقراض انسان یا «سلب اختیار دائمی و شدید، یا وضعیتی مشابه آن، برای گونه انسان» شود. مدیران ارشد شرکتهای بزرگ سالهاست هشدارهایی مشابه میدهند، اما خودشان بر اساس این هشدارها اقدام نکردهاند.
برخی، هشدارهای شدید آزمایشگاههای بزرگ را نوعی ترفند بازاریابی میدانند که با هدف بزرگنمایی قابلیتهای مدلهای آنها طراحی شده است: «محصول ما میتواند جهان را نابود کند؛ تصور کنید برای KPIهای شما چه کارهایی میتواند انجام دهد.» برخی دیگر آن را تلاشی برای حفظ برتری تجاری خود میدانند. آیدن گومز، بنیانگذار یک آزمایشگاه کوچک هوش مصنوعی به نام Cohere میپرسد: «آیا باید به چند شرکت منتخب و مسلط بر بازار هوش مصنوعی در سیلیکونولی اجازه داده شود قواعد و استانداردهای ایمنی یک فناوری نسلی را برای تمام جهان تعیین کنند؟»
دیوید ساکس، مشاور سابق کاخ سفید در حوزه هوش مصنوعی میگوید اگر آزمایشگاهها میخواهند سرعت خود را کاهش دهند، میتوانند چنین کاری کنند و به اجازه هیچکس دیگری نیاز ندارند. از دیدگاه او، درخواست برای مداخله دولت صرفاً به معنای درخواست از دولت برای محافظت از شرکتهای پیشرو در برابر رقابت است. آمودی استدلال میکند که دستکم به معافیتی از قوانین رقابت نیاز است تا از این امر جلوگیری شود که یک کاهش سرعت داوطلبانه و جمعی، بهعنوان تبانی «انحصاری چندتایی» یا اصطلاحاً «الیگوپولیستی» تلقی شود.
شاید بزرگترین منتقد این رویکرد، دونالد ترامپ باشد. رئیسجمهور آمریکا این هفته در میانه یک سخنرانی با جنسن هوانگ، مدیرعامل انویدیا تماس گرفت تا هر دو بتوانند علناً با کاهش سرعت مخالفت کنند. ترامپ در پستی در شبکههای اجتماعی گفت: «تنها کنترلی که هوش مصنوعی به آن نیاز دارد یا تنها سازوکارهای حفاظتی، یک رئیسجمهور قدرتمند و باهوش (با IQ بالا!) است.» او با متهمکردن آمودی به اینکه خود را در نقش «فرشته کوچولوی بینقص» جا میزند، اعلام کرد که اگر آزمایشگاههای بزرگ ترمز پیشرفت را بکشند، تنها چین از این وضعیت سود خواهد برد.
تماس ناگهانی ترامپ با جنسن هوانگ:
وقتی رئیسجمهور آمریکا زنگ زد و روی اسپیکر از هوش مصنوعی دفاع کرد
مذاکرات میان آمریکا و چین درباره هوش مصنوعی پرتنش است. نهتنها دو طرف در سطح ژئوپلیتیکی به یکدیگر اعتماد ندارند، بلکه میان آزمایشگاههای آمریکایی و چینی نیز روابط دوستانهای وجود ندارد. شرکتهای آمریکایی، شرکتهای پیشرو چینی در حوزه هوش مصنوعی را به کپیبرداری از دستاوردهای خود متهم میکنند. در مقابل، شرکتهای چینی معتقدند شرکتهای آمریکایی تلاش میکنند پیشرفت آنها را محدود کنند. یک پست پربازدید در ویچت که گفته میشود نوشته یک مهندس DeepSeek است، هشدار میدهد جهانی که در آن آنتروپیک هوش مصنوعی ابرهوشمند ایجاد کند، «چیزی کمتر از این نخواهد بود که هیتلر پیش از متفقین به فناوری بمب اتم دست پیدا کند». این مهندس استدلال میکند تنها درصورتیکه آنتروپیک در رقابت با هوش مصنوعی متنباز شکست بخورد، آیندهای بهتر و «کمونیستی» امکانپذیر خواهد بود.
رقبای سرسخت در گذشته برای مهار تهدیدهای متوجه بشریت با یکدیگر همکاری کردهاند. اما به نظر میرسد اجرای توافقهایی برای محدودکردن آموزش سامانههای هوش مصنوعی فوقالعاده قدرتمند، حتی از نظارت بر ذخایر سلاحهای هستهای نیز دشوارتر باشد.
ایدههایی در این زمینه مطرح شده است. مقالهای که سال گذشته منتشر شد پیشنهاد میکرد تمام تراشههای مورداستفاده برای آموزش هوش مصنوعی همراه با یک سامانه دوم فروخته شوند که برای پایش نحوه استفاده از آنها طراحی شده باشد. بااینحال، راهاندازی چنین رویکردی به زمان نیاز دارد و پس از آن نیز انگیزهای برای پنهانکردن فرایند تولید تراشهها ایجاد خواهد کرد.
گزارش جدیدی از Future Society، یک سازمان غیرانتفاعی فعال در حوزه ایمنی هوش مصنوعی، استدلال میکند که چنین نظارتی غیرممکن نیست، اما برایآنکه در توافقهای بینالمللی قابلاستفاده باشد، باید همین حالا روی آن سرمایهگذاری و پژوهش انجام شود. بخشی از این سرمایهگذاری میتواند از سوی کشورهای ثالث انجام شود؛ کشورهایی که از یک سو به پیشرفت کلی هوش مصنوعی علاقهمندند و ازسویدیگر نمیخواهند هیچ کشور واحدی بر این فناوری مسلط شود.
اما مانند همیشه، فناوری با سرعتی بیشتر از نهادهای نظارتی بالقوه در حال حرکت است. «آموزش توزیعشده» (Distributed Training) که در آن مدلهای هوش مصنوعی بهجای استفاده از مراکز داده عظیم، با استفاده از ظرفیت پردازشی بلااستفاده رایانههای معمولی آموزش داده میشوند، در حال گسترش است. در ماه مارس امسال، Covenant AI با استفاده از همین روش مدلی را آموزش داد که از نظر توانایی تقریباً به سطح بهترین سامانههای سال ۲۰۲۳ رسید. ممکن است ردیابی فرایند آموزش مدلهای جدید بهزودی بهاندازه آگاه ماندن از کارهایی که خود هوش مصنوعی انجام میدهد، دشوار شود.
گزارش حاضر در نسخه September 19th 2026 نشریه The Economist منتشر شده است.