FLUX 3
مدل مولد ویدئو FLUX 3؛ حرکت بهسوی مدلهای جهان واقعی
سید محمدجواد فیاض
- ۴ مرداد ۱۴۰۵
استارتاپ Black Forest Labs از مدل جدید مولد ویدئو خود به نام FLUX 3 رونمایی کرد؛ یک مدل پایه چندوجهی که با هدف ایجاد درک جامعتری از جهان طراحی شده است.
FLUX 3 از تصاویر، ویدئوها و صدا در یک معماری یکپارچه یاد میگیرد. هیچکدام از وجههای اطلاعاتی بهتنهایی توصیف کاملی از جهان ارائه نمیدهد. هرکدام از آنها یک تصویر از همان واقعیت زیربنایی هستند که توسط حسگرهای مختلف ثبت شدهاند و هر یک در این فرایند بخشی از اطلاعات را از دست میدهد. تصاویر، ساختارهای فضایی و روابط میان اشیا را در یک لحظه مشخص ثبت میکنند. ویدئو بُعد زمان را بازمیگرداند و پویاییهای زمانی و قوانین فیزیکی را آشکار میکند. صدا نیز روابط علّی میان پدیدههای مکانیکی و ویژگیهای صوتی را آشکار میکند؛ روابطی که تنها از طریق بینایی قابلتشخیص نیستند. زبان این ادراکها را به اهداف، مفاهیم انتزاعی و دستورالعملها پیوند میدهد.
اگر یک مدل فقط از یکی از این وجهها یاد بگیرد، در نهایت یک مدل خوب از همان وجه خاص به دست میآید؛ اما اگر از همه آنها بهصورت همزمان یاد بگیرد، محدودیتها و ارتباطات متقابل میان آنها اطلاعات بیشتری ارائه میکنند؛ بهطوری که صدا باید با برخورد هماهنگ باشد، حرکت باید از جرم و قوانین فیزیکی پیروی کند و آینده باید از گذشته ناشی شود. در این حالت، وجههای مختلف دیگر عناصر جداگانه نیستند؛ بلکه به شواهدی درباره یک واقعیت زیربنایی واحد تبدیل میشوند.
FLUX 3 نخستین مدل این آزمایشگاه است که کاملاً بر اساس این اصل ساخته شده است؛ مدلی که قادر است در محیطهای فیزیکی و دیجیتال ادراک، پیشبینی و عمل کند.
FLUX 3 بر پایه رویکرد Self-Flow ساخته شده است؛ رویکردی که Black Forest Labs برای همترازی کارآمد تولید و درک چندوجهی درون یک معماری زیربنایی مشترک توسعه داده است. بر اساس این رویکرد، منابع محاسباتی و دادههای آموزشی به طور قابلتوجهی افزایش داده شده تا FLUX 3 را بهصورت همزمان روی ویدئو، تصویر و صدا آموزش ببیند.
در نتیجه، FLUX 3 قادر است وجههای مختلف اطلاعاتی را با یکدیگر ترکیب کند و تصاویر و ویدئو به همراه صدا را بهصورت مشترک تولید کند؛ هم از طریق دستورهای متنی ساده و هم با ارائه ورودیهای مرجع مانند تصاویر و ویدئوها.
FLUX 3 میتواند ویدئوهای بسیار متنوعی همراه با صدا، تا طول ۲۰ ثانیه را در یک فرایند تولید واحد ایجاد کند.
قابلیتهای اصلی آن شامل موارد زیر است (تمام خروجیها دارای تولید بومی صدا هستند):
- تولید ویدئو از متن (Text-to-Video Generation).
- تولید ویدئو از تصویر (Image-to-Video Generation)؛ چه با ادامهدادن از یک فریم آغازین («متحرکسازی») و چه با استفاده از تصاویر بهعنوان مرجع بصری.
- تولید ویدئو از ویدئو (Video-to-Video Generation) بر اساس یک کلیپ مرجع؛ بهگونهای که عناصر اصلی ویدئوی اولیه برای مثال همان شخصیت به یک صحنه یا زمینه جدید منتقل شوند.
- ادامه تولیدی ویدئو و صدا بر اساس ویدئو و صدای ورودی.
- تولید ویدئو از فریمهای کلیدی (Keyframe-to-Video Generation) برای ایجاد گذارهای کنترلشده میان لحظات مشخص.
- گفتوگوی چندزبانه.
- طیف گستردهای از سبکهای بصری و نسبتهای تصویر مختلف که بسیار فراتر از خروجیهای سینمایی مرسوم هستند.
- زنجیرهسازی عاملمحور (Agentic Chaining) از کلیپهای مجزا برای ساخت سکانسهای طولانیتر و چندنما.
- تنوع بالای سبک؛ FLUX 3 بهراحتی طیف گستردهای از سبکها، از تصاویر دوربینهای دستی آماتوری تا انیمیشن و تولیدات سینمایی را مدیریت میکند.
- تولید تایپوگرافی و طراحیهای متحرک.
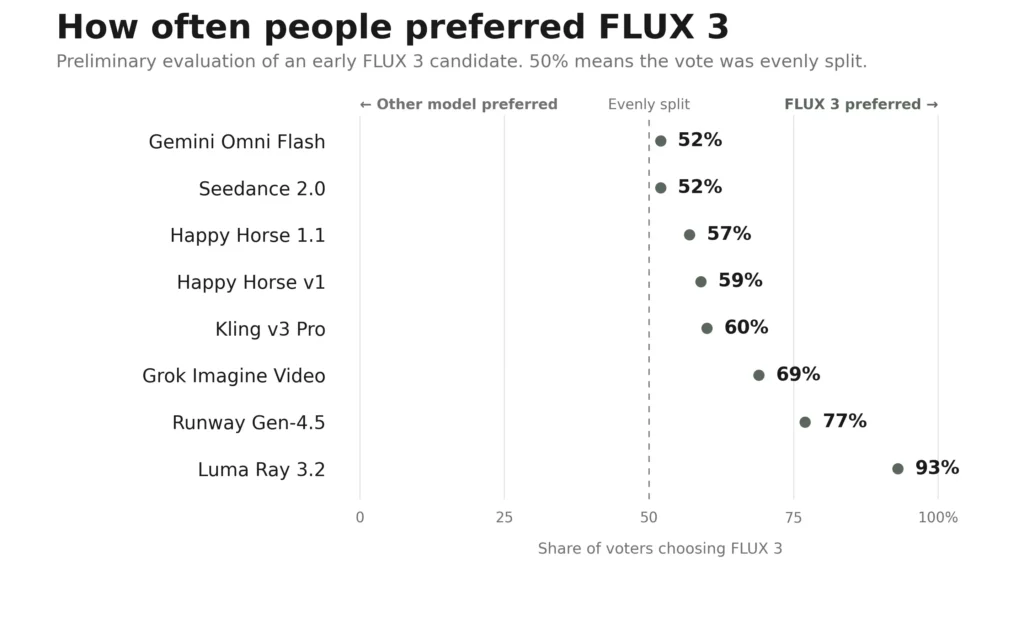
در ارزیابیهای اولیه، FLUX 3 در مقایسههای انجامشده در برابر مدلهای زیر ترجیح داده شد:
- Grok Imagine Video در حداکثر ۶۹ درصد مقایسهها،
- Kling v3 Pro در ۶۰ درصد،
- Happy Horse v1 در ۵۹ درصد،
- Happy Horse 1.1 در ۵۷ درصد،
- Seedance 2.0 و Gemini Omni Flash در ۵۲ درصد.
همچنین FLUX 3 در ۷۷ درصد مقایسهها نسبت به Runway Gen-4.5 و در ۹۳ درصد مقایسهها نسبت به Luma Ray 3.2 ترجیح داده شد.
باوجوداینکه FLUX 3 هنوز در مرحله توسعه قرار دارد، این مدل هماکنون در ثبت حالات چهره انسان، ارتباطدادن صداها با رویدادهای فیزیکی و قابلیتهای چندزبانه عملکرد قابلتوجهی دارد. علاوه بر این، این قابلیتها میتوانند با یکدیگر ترکیب شوند تا سکانسهایی چنددقیقهای ایجاد شود؛ سکانسهایی که در آنها مراجع بصری کمک میکنند شخصیتها در تمام صحنهها پایدار و سازگار باقی بمانند.
مدل FLUX 3 Video اکنون از طریق برنامه دسترسی اولیه در دسترس است.
همچنین FLUX 3 میتواند تصاویر را در طیف گستردهای از سبکها، نسبتهای تصویر و وضوحها تولید و ویرایش کند. در ارزیابیهای اولیه که در طول مرحله آموزش میانی (Midtraining) انجام شد، FLUX 3 هماکنون نسبت به نسخههای قبلی FLUX بهبود قابلتوجهی نشان میدهد؛ بهویژه در توانایی پردازش دستورهای پیچیده و تولید متن. این مدل طیف گستردهای از سبکهای خروجی را تولید میکند و قادر است متنهایی با دقت بالا را به زبانهای مختلف نمایش دهد. مانند ارزیابیهای ویدئویی، این نتایج نیز مقدماتی هستند و انتظار داریم پیش از انتشار نهایی، بهبودهای بیشتری ایجاد شود. ما در هفتههای آینده مرحله دسترسی اولیه برای FLUX 3 Image را آغاز خواهیم کرد.
درک جهان توسط FLUX 3 به پیشبینی اقدامها نیز گسترش پیدا میکند. برای دستیابی به این قابلیت، دو مسیر دنبال شده است:
- نخست، ادغام قابلیت پیشبینی اقدام بهصورت بومی در خود FLUX 3؛ مسیری که ادامه و توسعه کارهای اولیه این آزمایشگاه در Self-Flow است.
- دوم، استفاده از مبناهای ویدئویی آموزشدیده مدل بهعنوان یک پایه آگاه از پویاییهای جهان (Dynamics-aware Foundation) که میتوان مدلهای تخصصی عمل را با استفاده از دادههای محدود و اختصاصی هر وظیفه، روی آن فاینتیون کرد.
در هفتهها و ماههای آینده، قابلیتهای زیر پس از گذراندن یک مرحله دسترسی اولیه ارائه خواهد شد. تمامی این قابلیتها بر پایه یک مدل زیربنایی یکسان از Flow Matching چندوجهی ساخته شدهاند.
این قابلیتها و مدلها شامل موارد زیر هستند:
- تولید و ویرایش ویدئو و صدا از طریق APIها و دسترسی خصوصی به وزنهای مدل (FLUX 3 Video).
- تولید و ویرایش تصویر از طریق APIها و دسترسی خصوصی به وزنهای مدل (FLUX 3 Image).
- دسترسی آزاد به وزنهای یک مبنای چندوجهی برای تولید محتوا (ویدئو، صدا و تصویر) و پیشبینی عمل (FLUX 3 Dev).