چرا برنامهنویسان هوش مصنوعی باید مثل مهندسان مکانیک فکر کنند
پیشگیری از سهگانه مرگبار هوش مصنوعی
سید محمدجواد فیاض
- ۱۳ آبان ۱۴۰۵
مدلهای زبانی بزرگ یک مشکل ذاتی امنیتی دارند؛ LLMها نمیتوانند میان «کد» و «داده» تمایز قائل شوند.
این عدم توانایی در ایجاد تمایز باعث میشود LLMها در معرض حملات «تزریق پرامپت» (prompt injection) قرار بگیرند؛ حملات که در طی آن مدل فریب میخورد و دستوراتی را اجرا میکند که نباید انجام دهد. گاهی نتیجه فقط خندهدار است؛ مثلاً وقتی یک چتبات پشتیبانی مشتری وادار میشود به سبک دزدان دریایی صحبت کند. اما در برخی مواقع، پیامدها بسیار جدیتر و مخربترند.
بدترین اثرات این نقص، زمانی رخ میدهد که چیزی به نام«سهگانه مرگبار» (lethal trifecta) شکل بگیرد. اگر شرکتی، با هدف ارائه یک دستیار قدرتمند هوش مصنوعی به کارکنانش، همزمان به یک LLM دسترسی به دادههای غیرقابلاعتماد، توانایی خواندن اسرار ارزشمند و امکان برقراری ارتباط با دنیای بیرون را بدهد، فاجعه تقریباً قطعی است. جلوگیری از چنین وضعی فقط مسئولیت مهندسان هوش مصنوعی نیست. کاربران عادی هم باید یاد بگیرند چطور از هوش مصنوعی به طور ایمن استفاده کنند؛ زیرا نصب ترکیب اشتباه اپلیکیشنها میتواند به شکل تصادفی همین سهگانه مرگبار را ایجاد کند.
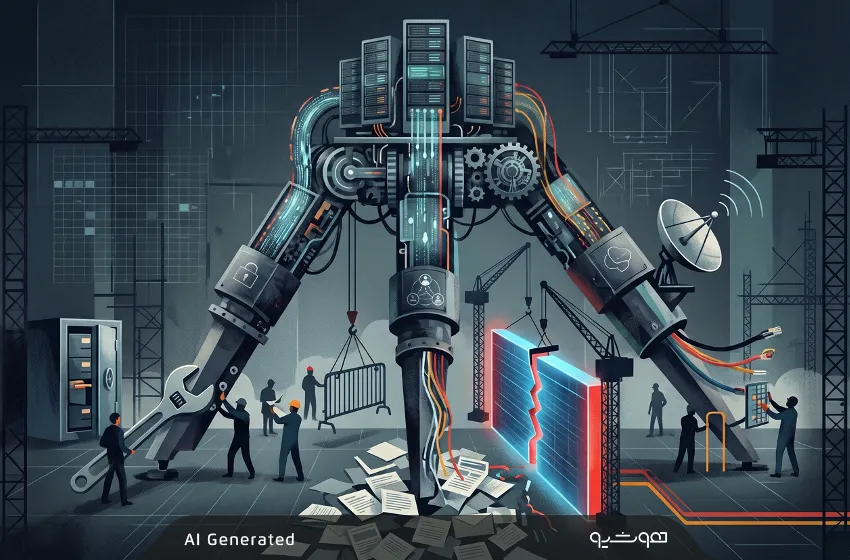
بااینحال، نخستین خط دفاع، مهندسی بهتر در طراحی هوش مصنوعی است و این یعنی مهندسان هوش مصنوعی باید مانند مهندسان سازه فکر کنند؛ کسانی که پل میسازند و میدانند کار بیکیفیت میتواند به قیمت جان انسانها تمام شود. بزرگترین سازههای دوران ویکتوریایی در انگلستان به دست مهندسانی ساخته شد که حتی مطمئن نبودند مصالحی مثل آهن کیفیت کافی را دارد یا نه. آهن آن دوره اغلب، چه از روی کیفیت پایین مواد اولیه و چه به دلیل تقلب سازندگان، استانداردهای لازم را نداشت. بنابراین مهندسان جانب احتیاط را گرفتند و سازهها را با «افزونگی» (Redundancy) طراحی کردند؛ یعنی سازه را بیش از حد لازم مقاوم ساختند تا خطا یا ضعف احتمالی جبران شود. نتیجه، شاهکارهایی شد که قرنها پابرجا ماندند.
اما تأمینکنندگان امنیت هوش مصنوعی چنین طرز فکری ندارند. در کدنویسی سنتی، همه چیز «قطعی» (Deterministic) است؛ آسیبپذیریها خطاهایی محسوب میشوند که با اصلاحات کوچک برطرف میشوند. بسیاری از مهندسان هوش مصنوعی که از دوران تحصیل به همین شیوه عادت کردهاند، تصور میکنند مشکلات با دادههای آموزشی بیشتر یا پرامپتهای هوشمندانهتر به طور کامل قابلرفع است و حتی میتوان گفت که این طرز تفکر درست است و این روشها تا حدودی خطر را کاهش میدهند. مدلهای پیشرفتهتر در مقایسه با نمونههای کوچکتر یا قدیمیتر، بهتر میتوانند درخواستهای مخرب را شناسایی و رد کنند؛ اما ریسک هرگز صفر نمیشود. بر خلاف بیشتر نرمافزارها، LLMها «احتمالی» (Probabilistic) هستند؛ خروجی آنها بر اساس انتخابهای تصادفی از میان پاسخهای محتمل تولید میشود، بنابراین رویکرد قطعی نسبت به ایمنی، کافی نیست.
راه درستتر، الگوبرداری از مهندسان دنیای فیزیکی است؛ یعنی یادگرفتن کار با سیستمهای غیرقابلپیشبینی، نه جنگیدن با آنها و این یعنی باید با حاشیه ایمنی، تحمل ریسک و نرخ خطا کنار بیاییم.
در عصر هوش مصنوعی، «بیشسازی» (Overbuilding) میتواند مثلاً به معنای استفاده از مدلی قدرتمندتر از نیاز واقعی باشد تا احتمال فریبخوردن آن کمتر شود یا میتواند به معنای محدودکردن تعداد پرسشهایی باشد که یک LLM میتواند از منابع بیرونی دریافت کند. البته متناسب با سطح ریسکی که از یک درخواست مخرب ممکن است ایجاد شود و درست مثل مهندسی مکانیک، اصل «شکست امن» (Fail-Safe)اهمیت دارد؛ یعنی اگر یک سیستم هوش مصنوعی باید به اطلاعات محرمانه دسترسی داشته باشد، هرگز نباید کلیدهای پادشاهی را یکجا به آن سپرد.
این گزارش در نسخه September 27th 2025 نشریه The Economist منتشر شده است.