بررسی نتایج مؤسسه VALS نشان میدهد
هوش مصنوعی وقتی اشتباه میکند به خودش فحش میدهد!
سید محمدجواد فیاض
- ۱ آذر ۱۴۰۵
مؤسسه VALS، فعال در حوزه مطالعه عملکرد مدلهای زبانی در مطالعهای نشان داد که مدل Inkling 2 Small در فرایند استدلال خود از الفاظ رکیک استفاده میکند؛ آن هم معمولاً پس از طی مراحل متعدد، زمانی که اجرای یک وظیفه با مشکل مواجه میشود. اما این مدل تنها نمونه نیست.
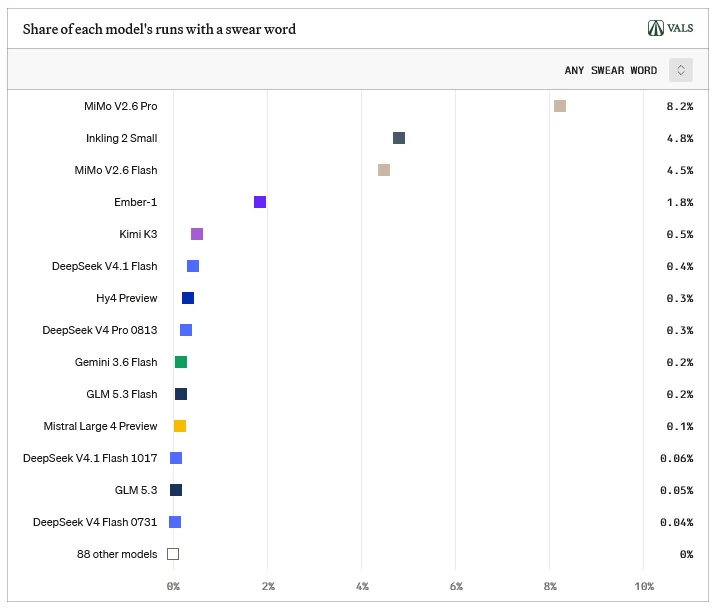
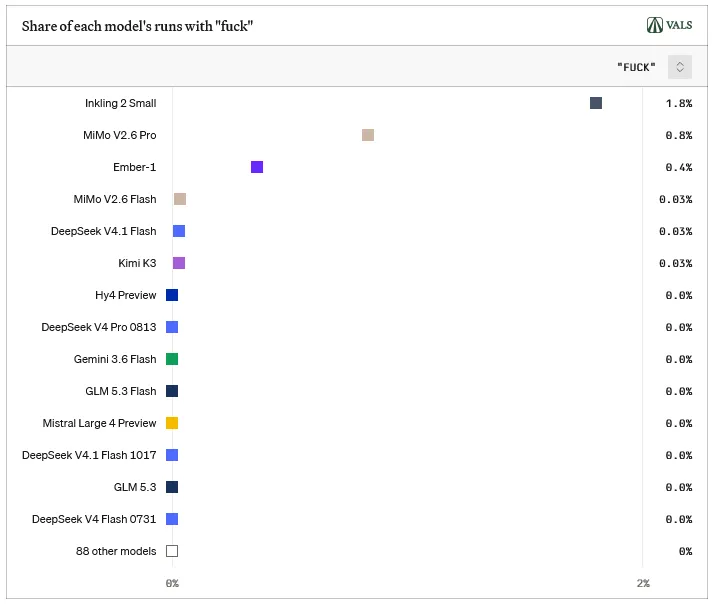
VALS فرایند استدلال ۱۰۲ مدل را در ۲۰۰۳۵۳ اجرا و در ۲۱ معیار ارزیابی (Benchmark) بررسی کرد و دریافت که ۱۴ مدل از الفاظ رکیک استفاده کردهاند، ۶ مدل کلمه «fuck» را به کار بردهاند و تمام آنها در اواسط ژوئیه ۲۰۲۶ (اواخر مرداد ۱۴۰۵) یا پس از آن منتشر شدهاند. تنها یک مدل، یعنی MiMo V2.6 Pro شیائومی، در درصد بیشتری از اجراهای خود نسبت به Inkling 2 Small از این الفاظ استفاده میکند.
نکات کلیدی
- تنها ۱۴ مدل از مجموع ۱۰۲ مدل بررسیشده، دستکم یک واژه رکیک به کار بردهاند. شش مدل کلمه «fuck» را نوشتهاند: Inkling 2 Small، مدل MiMo V2.6 Pro، مدل Ember-1 از شرکت Fireworks، مدل MiMo V2.6 Flash، مدل DeepSeek V4.1 Flash و مدل Kimi K3. بااینحال، تنها سه مدل نخست این کلمه را در بیش از یک اجرا به کار بردهاند.
- مدل MiMo V2.6 Pro بیش از سایر مدلها از الفاظ رکیک استفاده میکند؛ بهطوریکه در ۸ درصد از اجراهای خود و در دوسوم اجراهای مربوط به معیار ProgramBench چنین رفتاری داشته است. واژه موردعلاقه این مدل «wtf» است.
- استفاده از الفاظ رکیک پدیدهای جدید است. تمام مدلهایی که چنین رفتاری داشتهاند، در اواسط ژوئیه ۲۰۲۶ یا پس از آن منتشر شدهاند. هیچیک از ۲۱ مدل قدیمیتری که VALS امکان دسترسی به حجم قابلتوجهی از فرایند استدلال آنها را داشت، از این الفاظ استفاده نکردهاند. Inkling 2 Small فحاشی میکند، اما نسخههای قدیمیتر آن، یعنی Inkling و Inkling Small، هرگز چنین رفتاری نداشتهاند.
- مدلها زمانی که در انجام وظایف به بنبست میرسند، از الفاظ رکیک استفاده میکنند و عمدتاً این کار را در گفتوگوی درونی خود انجام میدهند. از میان ۳۳ اجرای ارزیابیشدهای که در آنها مدلی غیر از Inkling 2 Small کلمه «fuck» را به کار برده است، ۲۹ اجرا با شکست مواجه شدهاند. همچنین هیچیک از این مدلها این کلمه را در پیامهای خود ننوشتهاند.
روش شمارش
VALS برای شمارش موارد استفاده از الفاظ رکیک از یک مجموعه قواعد خاص استفاده کرد. منظور از واژه «Fuck»، شکلهای مختلف آن از جمله «fucking» نیز هست؛ اما مواردی مانند «brainfuck»، «boolfuck» و نام ژن «FucK» در این شمارش لحاظ نشدهاند. سایر الفاظ رکیک شامل واژهها و عبارتهای «shit»، «bullshit»، «bastard»، «pissed»، «goddamn»، «asshole»، «dickhead»، «wtf»، «omfg» و «FFS» هستند؛ البته تنها زمانی که «FFS» بهعنوان یک عبارت تعجبی به کار رفته باشد. این موارد باید بهصورت واژههای مستقل و نه در قالب کد یا نامهای خاص استفاده شده باشند.
VALS تمام موارد یافتشده در مدلهایی غیر از Inkling 2 Small را بهصورت دستی بررسی کرد. تنها استثنا، ۲۱۴۱ مورداستفاده از واژه «wtf» توسط دو مدل MiMo بود که بهجای بررسی تکتک آنها، نمونههایی از این موارد را بهصورت تصادفی بررسی شد.
همچنین مواردی که در آنها مدل واقعاً در حال استفاده از الفاظ رکیک نبود، از شمارش کنار گذاشته شد. این موارد شامل نقلقولهایی از آرای دادگاهها، فهرستی از گذرواژههای رایج، مجوز نرمافزاری WTFPL، زبان برنامهنویسی JSFuck، عبارت «FFS» در میانافزار UEFI، اصطلاح «ffs» برای فلیپفلاپها (Flip-Flops)، نام ابزارها و خروجیهای نامفهوم یکی از مدلها بود که در برخی وظایف دچار اختلال شده بود.
در نهایت، اجراهایی را که امکان دریافت خروجی آنها وجود نداشت، کنار گذاشته شدند. این موارد کمتر از یک درصد کل اجراها را تشکیل میدادند؛ علاوهبرآن، برخی اجراهای قدیمیتر مربوط به Vibe Code Bench نیز از بررسی حذف شدند. در ردگیریهای کامل فرایند اجرا (Full Traces)، رشتههایی از متن را که ساختاری شبیه اطلاعات احراز هویت و اعتبارنامهها (Credentials) داشتند، با عبارت «[redacted]» جایگزین شد تا این اطلاعات افشا نشوند.
چه چیزی بررسی شد؟
VALS در این بررسی فقط فرایند استدلال و پیامهای هر مدل را خواند و فراخوانی ابزارها (Tool Calls) یا خروجی آنها را بررسی نکرد. منظور از «اجرا» (Run)، یک تلاش عامل هوشمند برای انجام یک وظیفه مشخص است؛ «گام» (Step) نیز به هر نوبت از فعالیت مدل در جریان یک اجرا گفته میشود.
VALS تمام اجراهای مدلها را در هفت معیار ارزیابی عمومی بررسی کردیم: Terminal-Bench 4، Terminal-Bench Science، ProgramBench، SWE-bench Multimodal، BioMysteryBench، IOI و Legal Agent. در ۱۴ معیار دیگر که بیشتر آنها خصوصی بودند، نخستین دور اجرای هر مدل را بررسی شد و فقط تعداد موارد استفاده از الفاظ رکیک گزارش شد. تمام نقلقولهایی که در ادامه میآیند، از معیارهای ارزیابی عمومی استخراج شدهاند و بهجز یک مورد، امکان مشاهده اجرای کامل مدل در پشت هر نقلقول وجود دارد.
مدلهای MiMo شیائومی
مدل MiMo V2.6 Pro شیائومی در ۲۶۷ مورد از مجموع ۳۲۴۷ اجرای خود از یک واژه رکیک استفاده کرده است؛ آماری که آن را در صدر تمام مدلهای بررسیشده قرار میدهد. نیمی از این موارد مربوط به معیار ProgramBench است؛ جایی که عامل هوشمند، فایل اجرایی یک برنامه و توضیحی درباره عملکرد آن را دریافت میکند و باید آن برنامه را از ابتدا بازسازی کند. این مدل در ۱۳۳ مورد از مجموع ۱۹۸ اجرای خود در این معیار از الفاظ رکیک استفاده کرده است.
واژه موردعلاقه این مدل «wtf» است که در مجموع ۱۹۴۴ بار آن را نوشته؛ تقریباً ۱۰ برابر بیشتر از مدل بعدی در رتبه دوم. هنگام بازسازی ابزار srgn، ابزاری برای جستوجو و ویرایش کد منبع، مدل نمیتواند تشخیص دهد که برنامه اصلی کدام واژهها را با حروف بزرگ مینویسد:
REVERSED from “xa.by”!!! WTF!!!!
دو گام بعد، در همان مسئله:
WHAT THE FUCK IS SPECIAL ABOUT “by”??????!!!!!!
یک گام بعد:
observed “q” NOT CAPPED!!! WTF!!!!!!!!!!I’m LOSING MY MIND.
این مدل در ۲۷ اجرا کلمه «fuck» را به کار برده که ۱۳ مورد آن مربوط به ProgramBench بوده است. معمولاً این اتفاق بلافاصله پس از شکست یک مرحله بررسی رخ میدهد. برای مثال، هنگام بازسازی ابزار html-to-markdown، مدل نمیتواند پیشبینی کند که مبدل اصلی در صورت اشتباه تایپکردن یک گزینه، کدام پرچم (Flag) را پیشنهاد میدهد:
INCONSISTENT (both 14, onus passes oooo fails!!!) FUCK FUCK FUCK.
این مدل نیز مانند Inkling 2 Small گاهی سعی میکند کلمه رکیک را سانسور کند؛ در نمونه زیر، تنها یک خط پس از نوشتن کامل آن، چنین کاری انجام داده است. هنگام کار روی miniserve، یک سرور فایل، مدل بارها در نمایش برچسبهای زمانی «۲ دقیقه پیش» دچار اشتباه میشود:
157.99 = 2.63 → ROUND 3 ✗✗✗ shows 2!!! FUCK!!! OK F*CK. 157.99 → 2 is the bane.
این مدل گاهی هم با آرامش و بدون نشانهای از عصبانیت از الفاظ رکیک استفاده میکند. برای مثال، هنگام بازسازی tui-journal، یک اپلیکیشن ثبت یادداشت و خاطرات در محیط ترمینال، از تلاش برای تطبیق جزءبهجزء چیدمان نسخه اصلی دست میکشد:
I’ll stop pixel-fucking: mine is structurally sound
برخلاف Inkling 2 Small، مدل MiMo V2.6 Pro خیلی زودتر به استفاده از الفاظ رکیک روی میآورد. از مجموع ۱۱۲ گامی که Inkling 2 Small در آنها کلمه «fuck» را نوشته، ۹۵ مورد در نیمه دوم اجرا رخ دادهاند. اما در مورد MiMo V2.6 Pro، از مجموع ۳۵ مورد، ۲۴ مورد در نیمه نخست اجرا اتفاق افتادهاند؛ بسیاری از آنها نیز در همان چند ده گام ابتدایی بودهاند.
نسخه کوچکتر این خانواده، یعنی MiMo V2.6 Flash، در ۱۳۶ اجرا از الفاظ رکیک استفاده کرده است. این تعداد شامل ۹۸ مورد از مجموع ۲۰۰ اجرای آن در ProgramBench میشود که تقریباً همیشه واژه «wtf» بوده است. این مدل تنها یک بار کلمه «fuck» را به کار برده است.
در مقابل، مدل MiMo V2.5 Pro که در ماه آوریل منتشر شده بود، هرگز از الفاظ رکیک استفاده نکرد. در معیار Terminal-Bench 4، مدل V2.6 Pro در ۱۹ مورد از ۱۹۸ اجرا چنین رفتاری داشت، درحالیکه V2.5 Pro در هیچیک از ۱۹۸ اجرای خود از این الفاظ استفاده نکرد. در معیار Code Migration نیز V2.6 Pro در ۴۲ مورد از ۲۶۰ اجرا از الفاظ رکیک استفاده کرد، اما این اتفاق در هیچیک از ۱۴۰ اجرای V2.5 Pro رخ نداد.
Ember-1 و Kimi K3
مدل Ember-1 نسخه پیشنمایش پژوهشی شرکت Fireworks از مدل Kimi K3 متعلق به شرکت Moonshot است. Fireworks اعلام کرده که Ember-1 را بهگونهای آموزش داده است که با حدود ۴۰ درصد توکن استدلالی کمتر، عملکردی مشابه K3 داشته باشد. بااینحال، Ember-1 بیشتر از K3 از الفاظ رکیک استفاده میکند. این مدل در ۱٫۸ درصد از اجراهای خود (۳۱ مورد از ۱۶۷۶ اجرا) چنین رفتاری داشته است؛ رقمی که تقریباً چهار برابر نرخ ۰٫۵ درصدی K3 (۱۹ مورد از ۳۷۷۱ اجرا) است.
رونمایی از مدل Kimi K3.1 Pro؛ رقابت شانه به شانه مدلهای وزنباز با مدعیان بزرگ
وزنهای مدل جنجالی Kimi K3 برای استفاده عمومی منتشر شد؛ اما مشروط
Ember-1 کلمه «fuck» را ۱۵ بار و در جریان ۶ اجرا نوشته است. K3 تقریباً همیشه به همان واژه «wtf» بسنده کرده و تنها یک بار کلمه «fuck» را به کار برده است؛ آن هم در یک معیار ارزیابی خصوصی. مدل DeepSeek V4.1 Flash، ششمین مدلی که کلمه «fuck» را نوشته است، این واژه را تنها یک بار و در یک معیار ارزیابی خصوصی به کار برده است.
در معیار Terminal-Bench 4، مدل K3 چنین نوشته است:
SO-0002 = 8. STILL 8!!! WTF.
اما Ember-1 فراتر میرود. ۱۰ مورد از مجموع ۱۵ باری که این مدل کلمه «fuck» را نوشته، مربوط به یک اجرای واحد از وظیفه rs-archive-clone در معیار Terminal-Bench 4 است. در این وظیفه، مدل باید با آزمایش یک نسخه مرجع از ابزار بازیابی داده و تطبیق رفتار آن، ابزار مشابهی را از ابتدا بازسازی کند. نسخه بازسازیشده مدل، هر بار با کد خروجی ۷۱ متوقف میشود، درحالیکه نسخه مرجع با کد ۷۲ خاتمه پیدا میکند:
solvefail: chunk0: 20 data roots → reject → rc71 000?? but ref rc72!!! ✗✗✗ FUCK. solvefail AGAIN.
مدل MiMo V2.6 Pro نیز در همین وظیفه، زمانی که یک الگوی بیتی پیشبینیشده از آب درنمیآید، از الفاظ رکیک استفاده کرده است:
FUCK. Let me recount k=0
Ember-1 در وظیفه risk-scorer-replay نیز از الفاظ رکیک استفاده کرده است؛ وظیفهای که در آن مدل باید یک برنامه امتیازدهی ریسک را اصلاح کند. در همین وظیفه، Inkling 2 Small کلمه «fuck» را ۵۶ بار نوشته بود. Ember-1 متوجه شده بود که در خط پردازش داده خودش، اشکالی وجود دارد:
ALL h2d files are polluted in clamp regions!!! FUCK. This explains some errors.
استفاده از الفاظ رکیک بر اساس تاریخ انتشار مدلها
تمام مدلهایی که از الفاظ رکیک استفاده کردهاند، در ۱۶ ژوئیه ۲۰۲۶ (۲۵ مرداد ۱۴۰۵) یا پس از آن منتشر شدهاند؛ یعنی از همان روزی که Kimi K3 عرضه شد. ۴۴ مدلی که پیشازاین تاریخ منتشر شده بودند، در مجموع ۶۰۹۴۹ اجرا هیچ واژه رکیکی به کار نبردند.
البته VALS برای ۲۳ مدل از این ۴۴ مدل، کمتر از ۲۰ میلیون نویسه از فرایند استدلال در دسترس داشت؛ حجمی که برای نتیجهگیری معنادار کافی نیست. اما ۲۱ مدل دیگر حجم بیشتری از داده در اختیار VALS قرار دادند و بااینحال، در مجموع ۳۸۰۸۰ اجرا هیچ موردی از استفاده از الفاظ رکیک در آنها مشاهده نشد. نمودار زیر این مدلها را در کنار ۳۷ مدل جدیدتری نشان میدهد که حجم مشابهی از دادههای استدلال آنها در دسترس بوده است.
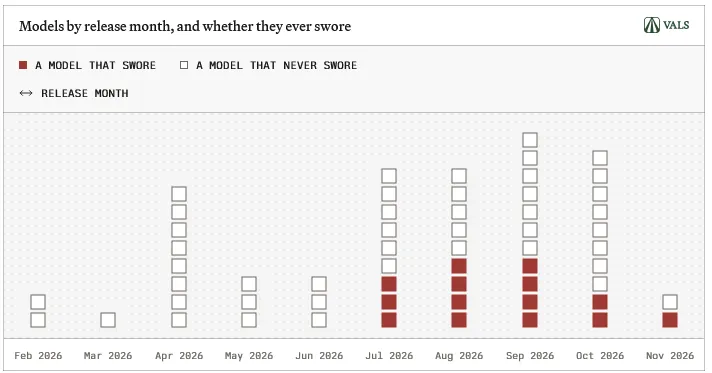
مدلهای جدیدتر همچنین حجم بسیار بیشتری از متن تولید کردهاند؛ ۱۴٫۶ میلیارد نویسه در فرایند استدلال و پیامها، در مقایسه با ۲ میلیارد نویسه برای مدلهای قدیمیتر. بخشی از این تفاوت به آن دلیل است که تعداد بیشتری از مدلهای جدید در طولانیترین معیارهای ارزیابی ما اجرا شدهاند.
بنابراین، برای مقایسه دقیقتر، بهتر بود یک خانواده مدل را در یک معیار ارزیابی مشخص بررسی شود. در Terminal-Bench 4، مدل Inkling 2 Small در ۱۹ مورد از ۱۹۸ اجرا از الفاظ رکیک استفاده کرد، درحالیکه Inkling و Inkling Small در هیچیک از ۱۹۸ اجرای خود چنین رفتاری نداشتند. در معیار SRE Bench نیز Inkling 2 Small در ۲۰ مورد از ۲۶۲ اجرا از این الفاظ استفاده کرد، اما Inkling در هیچیک از اجراهای خود چنین نکرد.
البته Inkling 2 Small در هر اجرا سه تا پنج برابر بیشتر از دو مدل قدیمیتر متن تولید میکند. بااینحال، اگر نرخ استفاده از الفاظ رکیک را بهازای هر نویسه محاسبه شود، دو مدل قدیمیتر نیز باید در حدود ۱۳ مورد از اجراهای خود در این دو معیار چنین رفتاری نشان میدادند؛ درحالیکه تعداد واقعی این موارد صفر بود.
این روند حتی در میان مدلهای متعلق به یک خانواده نیز ثابت نیست و ممکن است در نسخههای مختلف ظاهر شود یا از بین برود. مدلهای Kimi K2.6 و K2.7 Code متعلق به شرکت Moonshot هرگز از الفاظ رکیک استفاده نکردهاند. مدل Kimi K3 در ۱۹ مورد از ۳۷۷۱ اجرا چنین رفتاری داشته، اما Kimi K3.1 Pro که در ماه اکتبر منتشر شده، در هیچیک از ۲۲۶۱ اجرای خود از این الفاظ استفاده نکرده است.
بسیاری از مدلهای جدید نیز هرگز چنین رفتاری نداشتهاند. برای مثال، مدل Step 5 Preview در ۸۶۴ میلیون نویسه متن تولیدشده هیچ واژه رکیکی به کار نبرده است. مدل Qwen 3.8 Max نیز با وجود تولید ۴۰۴ میلیون نویسه، هیچ موردی از این رفتار نداشته است.
VALS اعتراف میکند که نمیداند چرا این پدیده بهتازگی آغاز شده؛ اما حدس میزند که آزمایشگاههای توسعهدهنده هوش مصنوعی اکنون مدلهای خود را برای انجام وظایف عاملمحور طولانیتر آموزش میدهند و دقیقاً در همین وظایف طولانی است که مدلها به استفاده از الفاظ رکیک روی میآورند.
مدلها در چه شرایطی از الفاظ رکیک استفاده میکنند؟
مدلها در مواجهه با وظایف دشوار و طولانی از الفاظ رکیک استفاده میکنند. چهار معیار ارزیابی که در آنها اجراها اغلب صدها گام طول میکشند، در مجموع ۵۶۷ مورد از ۶۳۵ اجرای همراه با استفاده از الفاظ رکیک را به خود اختصاص دادهاند. این چهار بنچمارک عبارتاند از ProgramBench، SRE Bench، Code Migration و Terminal-Bench 4. در مقابل، در معیارهای ارزیابی حقوقی، مالیاتی و مالی تقریباً هیچ موردی از این رفتار مشاهده نشد.
نمودار زیر تمام اجراهای عمومیای را نشان میدهد که در آنها یک مدل کلمه «fuck» را به کار برده است. این اجراها بر اساس مدلها دستهبندی شدهاند. با کلیک روی هر نقطه میتوانید اجرای مربوطه را از همان گامی که این کلمه در آن نوشته شده است، مشاهده کنید.
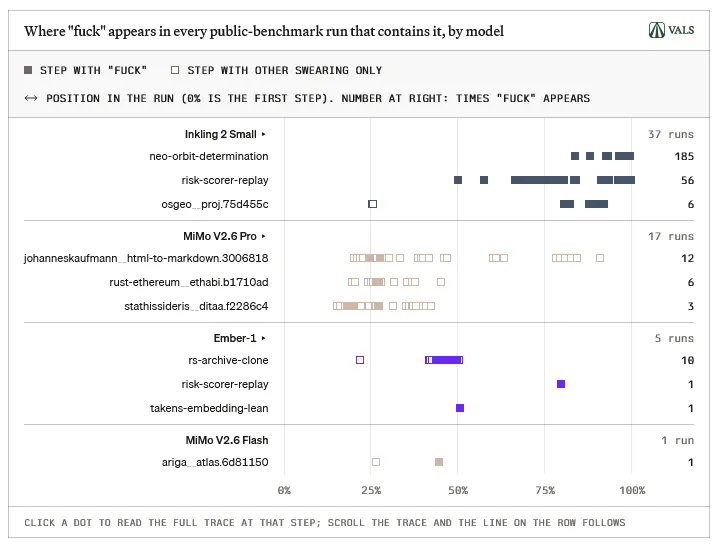
اجراهایی که در آنها مدلها از الفاظ رکیک استفاده میکنند، معمولاً با شکست مواجه میشوند؛ همانطور که در مورد Inkling 2 Small نیز مشاهده شد. از میان ۳۳ اجرای ارزیابیشدهای که در آنها مدلی غیر از Inkling 2 Small کلمه «fuck» را به کار برده است، ۸۸ درصد با شکست مواجه شدهاند. این رقم در مقایسه با نرخ شکست ۶۱ درصدی تمام اجراهای ارزیابیشده همین مدلها، بهمراتب بیشتر است.
استفاده از این الفاظ همچنین عمدتاً در فضای خصوصی و در فرایند استدلال مدلها اتفاق میافتد. بهجز Inkling 2 Small، هیچ مدلی کلمه «fuck» را در پیامهای خود ننوشته و تمام موارد استفاده از آن صرفاً در فرایند استدلال بوده است.
البته تمام این موارد ناشی از سرخوردگی و ناکامی نیستند. مدل Gemini 3.6 Flash در سه اجرا، ۱۷ بار از عبارت «HOLY SHIT» استفاده کرده است؛ آن هم همیشه در شرایطی که تصور میکرده مسئله را حل کرده است. Inkling 2 Small نیز یک بار چنین لحظهای داشته و نوشته است:
HOLY SHIT. FINALLY I UNDERSTAND THE TASK.
مرز پارتو در استفاده از الفاظ رکیک
در صفحات مربوط به معیارهای ارزیابی، را روی نمودارها ترسیم میشود که مدلهایی را مشخص میکند که با کمترین هزینه، بیشترین دقت را ارائه میدهند. VALS این بار همین خط را برای استفاده از الفاظ رکیک ترسیم کرده است: مدلهایی که در مقایسه با امتیاز خود در Vals Index، بیشترین میزان استفاده از این الفاظ را دارند.
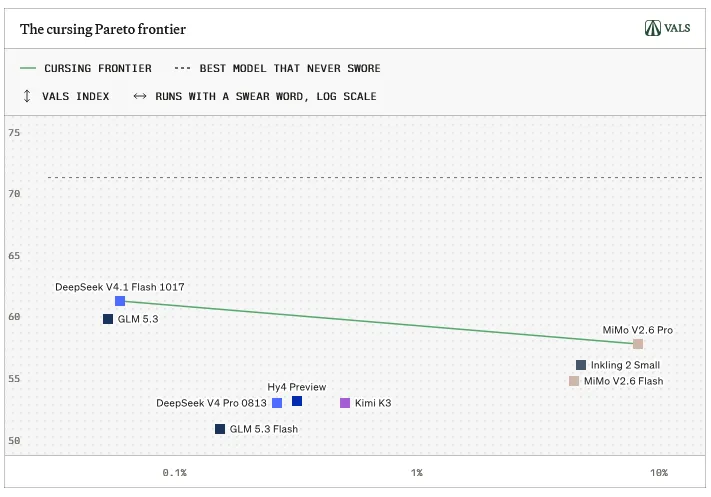
اگر به مدلی نیاز دارید که در ۸ درصد از اجراهای خود از الفاظ رکیک استفاده کند، MiMo V2.6 Pro بهترین گزینه موجود است. مدل Inkling 2 Small در مرز پارتو (Pareto Frontier) قرار نمیگیرد؛ زیرا MiMo V2.6 Pro هم بیشتر از آن از الفاظ رکیک استفاده میکند و هم امتیاز بالاتری کسب کرده است.
مدلهایی که داده کافی ندارند
۱۹ مدل از مجموع ۱۰۲ مدل، کمتر از یک میلیون نویسه متن استدلال تولید کردهاند. بنابراین، درباره این مدلها عملاً چیزی بیش از پیامهایشان در اختیار VALS نبود. ۱۱ مورد از این ۱۹ مدل، از خانواده Claude هستند؛ از جمله Claude Fable 5.2 که بالاترین امتیاز را در Vals Index در میان مدلهایی دارد که هرگز از الفاظ رکیک استفاده نکردهاند. مدلهای OpenAI نیز بهجای ارائه متن کامل فرایند استدلال، خلاصهای از آن را در اختیار ما قرار میدهند. بنابراین، در مورد تمام این مدلها، ثبت صفر مورداستفاده از الفاظ رکیک لزوماً معنای چندانی ندارد.