تولید دانش در عصر مدلهای زبانی بزرگ
سید محمدجواد فیاض
- ۲۲ فروردین ۱۴۰۵
با تحول سریع فرایند تولید علم، نهادهای سیاستگذار علمی باید به این بیندیشد که مؤسسات علمی چگونه میتوانند در این شرایط تکامل پیدا کنند.
با وجود افزایش هیجان و نگرانی پیرامون پذیرش سریع هوش مصنوعی مولد در تمامی رشتههای دانشگاهی، شواهد تجربی همچنان پراکنده است و درک نظاممند از اثرات مدلهای زبانی بزرگ در حوزههای مختلف علمی محدود باقی مانده است.
علم و LLM
نویسندگان مقاله حاضر در نسخه 18December 2025 نشریه Science، با تحلیل کلاندادههای سه مخزن اصلی پیشچاپ نشان میدهند که استفاده از LLMها سرعت خروجی دستنوشتهها را تسریع میکند، موانع پیش روی پژوهشگران غیرانگلیسیزبان را کاهش میدهد و روند اکتشاف در متون پیشین را گستردهتر میسازد.
بااینحال، نشانههای سنتی کیفیت علمی مانند پیچیدگی زبانی در حال تبدیلشدن به شاخصهایی غیرقابلاتکا برای سنجش شایستگی هستند؛ آن هم درست در زمانی که با افزایش کمّی تولیدات علمی مواجه شدهایم. با پیشرفت سامانههای هوش مصنوعی، مفروضات بنیادین ما درباره کیفیت پژوهش، ارتباطات علمی و ماهیت کار فکری به چالش کشیده خواهد شد. سیاستگذاران علم باید بیندیشند که چگونه نهادهای علمی را برای انطباق با فرایند بهسرعت در حال تغییر تولید علم تکامل دهند.
بنگاه علم به طور تنگاتنگی با نوآوری فناورانه پیوند خورده است. برای نمونه، میکروسکوپ، پیشرفتهای محاسباتی و توالییابهای نسل جدید مرزهای پژوهش را جابهجا کردهاند. پژوهشگران نیز ارزش هوش مصنوعی را در زمینههای علمی مشخصی از جمله پیشبینی ساختار پروتئین و کشف مواد نشان دادهاند.
روششناسی
پیشرفتهای اخیر LLMها، دامنه کاربرد آنها را به طیف وسیعی از وظایف در علوم طبیعی و علوم اجتماعی گسترش داده است. این آثار ظرفیت چشمگیر LLMها را در فعالیتهای علمی خاص برجسته میکنند، اما درعینحال یک پرسش باز را نیز مطرح میکنند، اثرات بزرگمقیاس LLMها بر بنگاه علم چیست؟
برای پاسخ به این پرسش، از سه مخزن پیشچاپ در بازه زمانی ژانویه ۲۰۱۸ تا ژوئن ۲۰۲۴ گردآوری شدهاند:
- پایگاه arXiv با ۱.۲ میلیون مقاله پیشچاپ در حوزه ریاضیات، فیزیک، علوم رایانه، مهندسی برق، زیستشناسی کمی، آمار و اقتصاد.
- پایگاه bioRxiv با ۲۲۱ هزار پیشچاپ که دامنه گستردهای از زیرشاخههای زیستشناسی و علوم زیستی را پوشش میدهد.
- پایگاه SSRN با ۶۷۶ هزار پیشچاپ که یک مخزن مقالات در حال کار است که دستنوشتههایی در علوم اجتماعی، حقوق و علومانسانی را میزبانی میکند.
هر یک از این سه مجموعهداده بزرگترین نمونه در حوزه خود هستند. در مجموع، آنها مبنای تجربی کمنظیری را برای بررسی برخی از اثرات LLMها بر رویههای بهرهوری علمی در رشتههای متعدد فراهم میکنند.
برای شناسایی نحوه و میزان استفاده از LLMها در خلق دستنوشتههای علمی، یک الگوریتم تشخیص هوش مصنوعی مبتنی بر متن روی همه چکیدههای مقالات اعمال شد. از چکیدههای مقالاتی که پیش از سال ۲۰۲۳؛ یعنی پیش از عرضه ChatGPT ارسال شده بودند، برای برآورد توزیع توکنها (واژهها) در متنهای نوشتهشده توسط انسان استفاده شد. سپس از مدل GPT-3.5-turbo-0125 متعلق به OpenAI خواسته شد این چکیدهها را بازنویسی کند و در نهایت توزیع توکنهای متنهای نوشتهشده توسط LLM تولید و با هم مقایسه شدند. این کار به پژوهشگران اجازه داد تفاوتهای توزیع واژگان میان نگارش کمکگرفته از LLM و نگارش انسانی را کمّیسازی کنند و چکیدههای احتمالاً کمکگرفته از LLM که پس از انتشار ChatGPT نوشته شدهاند را شناسایی کنند.
استفاده از LLM و بهرهوری علمی
پیشبینی میشود نویسندگانی که از LLMها استفاده میکنند، افزایش بهرهوری محسوسی را تجربه خواهند کرد. برای تفکیک اثرات عمومی بهرهوری LLMها از رشد سریع پژوهشهای مرتبط با هوش مصنوعی، ابتدا دستنوشتههای حوزههای اصلی هوش مصنوعی از نمونه حذف شدند. سپس پذیرش اولیه LLM توسط یک نویسنده را با نخستین دستنوشتهای (mi) که نشانههای آماری کمکگرفتن از LLM را نشان میداد (a) تعریف شد؛ بهگونهای که a(mi) > t که t آستانه تشخیص است. وضعیت پذیرش یک نویسنده برای هر ماهی که پس از نخستین استفاده شناساییشده رخ میدهد، از ۰ به ۱ تغییر میکند. بر مبنای این سنجه، تغییر در نرخ ارسال دستنوشتهها در میان پذیرندگان LLM و سایر افراد، پیش و پس از پذیرش و با استفاده از مدلهای رویدادی با اثرات ثابت در سطح نویسنده بررسی شد.
بهرهوری و انتشار
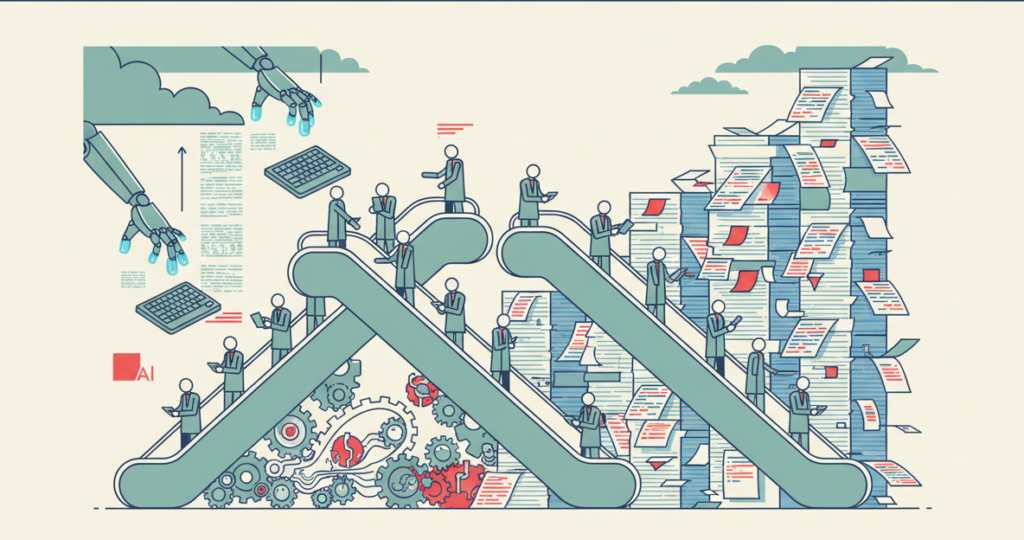
بین ژانویه ۲۰۲۲ و جولای ۲۰۲۴، تعداد پیشچاپهای ماهانه arXiv که پس از پذیرش LLM در نگارش توسط یک نویسنده منتشر شدهاند، نسبت به سایر افراد ۳۶.۲ درصد افزایش یافته است. از سال ۲۰۲۳ به بعد، در دستنوشتههایی که به کمک از LLM نوشتهشدهاند، پیچیدگی بالاتر نگارش در arXiv با احتمال کمتر انتشار همبسته است؛ درحالیکه این رابطه برای دستنوشتههایی که بدون کمک LLM نوشتهشدهاند، معکوس است.
پذیرش استفاده از LLM با افزایش چشمگیر خروجی علمی پژوهشگران در هر سه مخزن پیشچاپ همراه است. ضرایب برآوردشده برایarXiv ،bioRxiv و SSRN به ترتیب ۳۶.۲ درصد، ۵۲.۹ درصد و ۵۹.۸ درصد هستند که بیانگر آن است که استفاده از LLM با افزایشهای قابلتوجهی در بهرهوری مرتبط است. اگرچه ضرایب برآوردی بسته به روش تشخیص و آستانه بهکار رفته برای شناسایی پذیرش LLM تغییر میکنند، تحلیلهای حساسیت نشان میدهند که این همبستگی مثبت در برابر انتخابهای تحلیلی مختلف پایدار است.
جهش بهرهوری
جهش بهرهوری ممکن است از بهکارگیری هوش مصنوعی مولد در چندین وظیفه پژوهشی ناشی شود، از جمله ایدهپردازی، مرور ادبیات، کدنویسی، گردآوری داده یا تحلیل. بااینحال، تا به امروز LLMها احتمالاً بیشترین اثر را در نگارش داشتهاند. برای خلق آثار علمی متمایز، پژوهشگران باید استدلالهای نوشتاری قانعکننده ارائه دهند، استدلالها، روشها و نتایج را به ادبیات پیشین پیوند دهند، یافتههای مهم را با جزئیات و در بستر مناسب توضیح دهند و روشن سازند که از متن چه میتوان آموخت. این وظایف پیچیده نگارشی زمانبر هستند، بهویژه برای پژوهشگرانی که به زبانی غیر از زبان مادری خود مینویسند. ازاینرو، این سؤال مطرح شد که آیا اثر بهرهوریِ پذیرش LLM در میان سطوح مختلف تسلط زبانی نویسندگان متفاوت است یا خیر. ازآنجاییکه اکثریت پژوهشهای مهم در مجلات و کنفرانسهای انگلیسیزبان منتشر میشوند، انگلیسیزبانان مزیت قابلتوجهی در ارتباطات علمی داشتهاند. LLMها میتوانند نابرابریهای تسلط به زبان انگلیسی را کاهش دهند و به طور نامتقارن هزینه نگارش را در میان پیشینههای زبانی مختلف کاهش دهند.
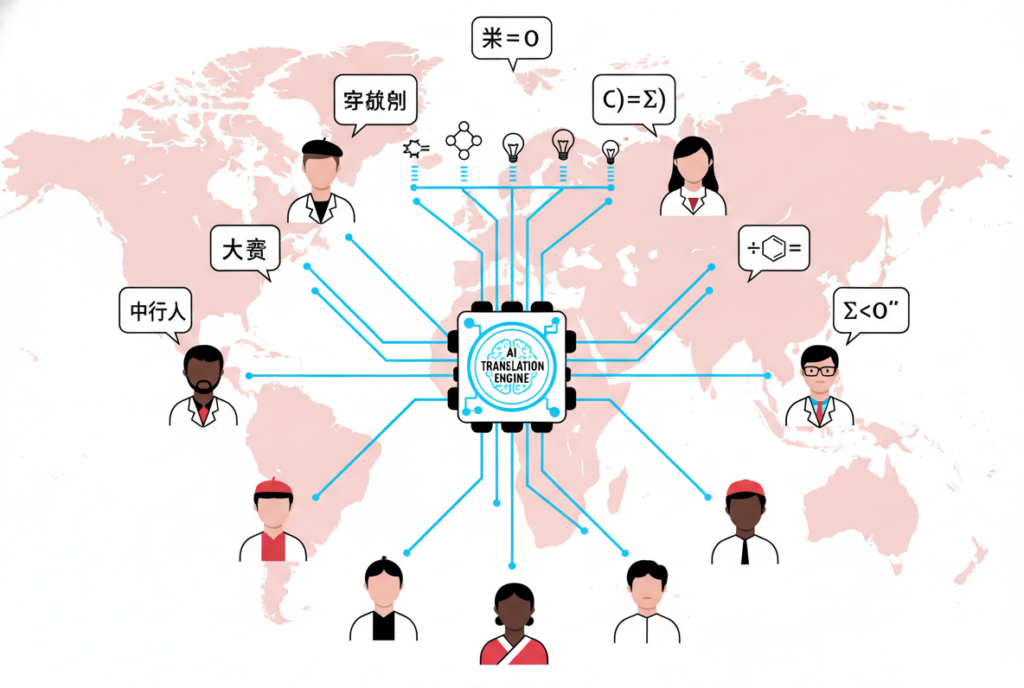
برای آزمون ناهمگنی تغییرات بهرهوری، احتمال انگلیسیزبان بودن یک نویسنده بر اساس نامها و مؤسسههای وابسته آنها تقریب زده شد. ضرایب به تفکیک قومیتها و جغرافیای مؤسسههای پژوهشگران گزارش شدند. اثرات در همه گروهها از نظر آماری معنادار باقی میمانند، اما در bioRxiv و SSRN، این اثر برای پژوهشگران با نامها و مؤسسههای آسیایی برجستهتر بود؛ بهطوریکه bioRxiv یک افزایش بهرهوری اضافیِ معنادار آماری را برای پژوهشگرانِ دارای نام آسیایی در نهادهای آسیایی (در مقایسه با نهادهای ایالات متحده، بریتانیا، کانادا و استرالیا) نشان میدهد. برای پژوهشگران دارای نام آسیایی و وابستگی نهادی در آسیا، افزایش بهرهوری مرتبط با LLM از ۴۳.۰ درصد در arXiv تا ۸۹.۳ درصد در bioRxiv و ۸۸.۹ درصد در SSRN برآورد شد. پژوهشگران دارای نامهای قفقازی و وابسته به نهادهای کشورهای انگلیسیزبان افزایشهای ملایمتر اما همچنان معناداری از ۲۳.۷ درصد در arXiv تا ۴۶.۲ درصد در SSRN را تجربه کردند.
نتیجه میگیریم که حتی استفاده از LLMهای نسل پیشین؛ آنهایی که در زمان نگارش دستنوشتههای مجموعهداده موردبررسی در دسترس پژوهشگران بودند، با افزایش بهرهوری مرتبط است؛ بهویژه برای پژوهشگرانی که با هزینههای بالاتر نگارش مواجهاند. این یافتهها با پژوهشهایی همخوانی دارد که نشان میدهند LLMها اثر نابرابریهای مهارتی را کاهش میدهند که در اینجا به شکل کاهش هزینه نگارش به زبان دوم خود را نشان میدهد. باتوجهبه پیشرفتهای قابلملاحظه در توان نگارشی LLMهای نسل کنونی و دسترسپذیری گستردهتر این سامانهها، اثرات بهرهوری برآوردشده احتمالاً بهاندازهای بزرگ خواهند بود که جابهجایی سهم بازار تولید علمی بهسوی پژوهشگران مناطق غیرانگلیسیزبان را القا کنند.
استفاده از LLM در نگارش علمی و پیامدهای انتشار
LLMها احتمالاً فراتر از اثرات بهرهوری، تولید علم را بازطراحی میکنند. نگارش باکیفیت اغلب بهعنوان نشانهای از شایستگی علمی تلقی میشود. مقالاتی با زبان روشن اما پیچیده؛ قویتر ارزیابی میشوند و بیشتر مورداستناد قرار میگیرند. ازآنجاییکه پیشرفتهای علمی حاصل سالها پالایش دانش هستند، توانایی بیان دقیق کشفیات علمی (هرچند بسیار ناقص) جانشینی برای میزان دقت صرفشده در کار یک تیم علمی است. این که LLMها میتوانند تقریباً بدون زحمت متنهایی صیقلیافته و حرفهای درباره هر موضوع علمی تولید کنند، پرسشی مهم را برمیانگیزد، آیا استفاده از LLM کیفیت پژوهشِ زیربنایی را آشکار میکند یا پنهان میسازد؟
برای ارزیابی این پرسش، نویسندگان مقاله بررسی کردند که پیچیدگی نگارش چگونه با کیفیت پژوهش مرتبط است و آیا پذیرش LLM قدرت آشکارسازی و سیگنالدهی پیچیدگی نگارش را در ارتباطات علمی تغییر میدهد یا نه. پیچیدگی نگارش با معکوس تجمعی شاخص Flesch Reading Ease سنجیده شد. این معیار پیچیدگی متن را بهصورت ترکیبی از میانگین طول جمله و تعداد هجا در هر واژه، کمّی میکند و امتیازهای بالاتر نشاندهنده متن پیچیدهتر هستند. بهعنوان جانشین کیفیت، پیامدی دودویی در قالب انتشار در یک مجله یا کنفرانس داوریشده تا پایان بازه مشاهده برای همه پیشچاپها از سال ۲۰۲۳ به بعد، تعریف شد.
وقتی معکوس تجمعی شاخص Flesch با پیامدهای انتشار همبسته شد، سه الگو پدیدار شد:
- نمرات پیچیدگی نگارش در دستنوشتههایی که با کمک LLM نوشتهشدهاند به طور معناداری بالاتر از مقالات نوشتهشده به زبان طبیعیِ انسانی در هر سه مخزن بودند. این امر توانایی چشمگیر LLMها در تولید نگارش علمی پیچیده را برجسته میکند.
- در مقالاتِ بدون کمک LLM در هر سه مخزن، پیچیدگی نگارش با کیفیت دستنوشته که با احتمال انتشار در یک مجرای داوریشده تقریب زده شده، همبستگی مثبت داشت. این نتایج پژوهشهای پیشین را تأیید میکنند که ارتباط مثبت میان پیچیدگی نگارش و شایستگی علمی را نشان دادهاند.
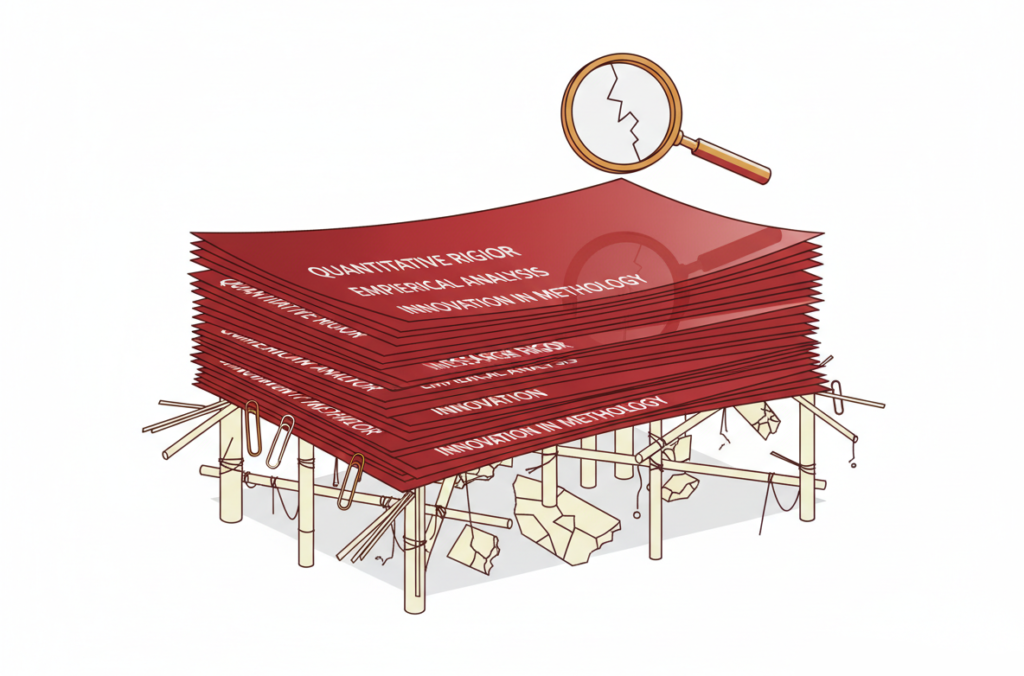
- وارونگی رابطه بسیار شدید و حتی بحرانی میان پیچیدگی نگارش و پیامدهای داوری همتا برای دستنوشتههای کمکگرفته از LLM مشاهده شد. برای این اسناد، افزایش پیچیدگی نگارش با ارزیابیهای پایینتر از شایستگی علمی همراه بود.
برای سنجش پایداری این یافتهها، ویژگیهای اضافی نگارش هم بررسی و نتایج با استفاده از پیچیدگی واژگانی (هجا بهازای هر واژه) و پیچیدگی صرفی (سهم بندهای وجه وصفی حال) بازتولید شد. هر دو این شاخصها همان الگوی وارونگی را نشان دادند؛ یعنی افزایش پیچیدگی نگارش در مقالات نوشتهشده با کمک LLM با موفقیت انتشار همبستگی منفی دارد، اما در مقالات نوشتهشده توسط انسان همبستگی مثبت وجود دارد. همچنین همان الگو را برای استفاده از زبان تبلیغاتی که با یک واژهنامه استاندارد سنجیده شد نیز یافت شد و بدینترتیب تأیید شد که پذیرش LLM نشانههای سنتی کیفیت را در ابعاد زبانی متعدد کمرنگ میکند.
آزمون پایداری
عوامل بسیاری بر پیامدهای انتشار پیشچاپها اثر میگذارند. نمیتوان همه عوامل مداخلهگر را کنار گذاشت، اما نتایج پس از کنترل ماه پیشچاپ و حوزه مطالعه همچنان سازگار باقی میمانند. بهعنوان آزمون پایداری، یک مجموعهداده مستقل از کنفرانس بینالمللی ICLR-2024 گردآوری و تحلیل شد. با استفاده از نمره داوری اختصاصیافته توسط داوران بهعنوان سنجهای جایگزین برای شایستگی علمی، یافتههای کلیدی با سازگاری چشمگیر بازتولید شدند.
تضاد زیاد در ارزیابیهای کیفیت در سراسر توزیع پیچیدگی زبانی میان دو گروه تأیید میکند که زبان پیچیده تولیدشده توسط LLM ، اغلب مشارکتهای علمی ضعیف را پنهان میکند. این یافتهها کمرنگشدن سریع یک میانبُر سنتی را نشان میدهند. برای دستنوشتههای کمکگرفته از LLM، همبستگی مثبت میان پیچیدگی زبانی و شایستگی علمی نهتنها ناپدید ، بلکه وارونه میشود. با حذف تلاشی که برای تولید نثر صیقلیافته لازم است، کارایی آن بهعنوان سیگنالی از تسلط نویسنده بر موضوع نیز کاهش مییابد. این امر خطری برای بنگاه علم ایجاد میکند؛ زیرا سیلی از پژوهشهای ظاهراً قانعکننده اما از نظر علمی سست، میتواند منابع علمی را اشباع کند. در چنین وضعی، جامعه علمی ناچار میشود زمان ارزشمندی را صرف جداسازی بینشهای اصیل از انبوهی از آثار کماهمیت و بالقوه گمراهکننده کند.
استفاده از LLM در مرور منابع
نگارش مقالات علمی همچنین مستلزم جایدادن ادعاها و یافتهها در دل ادبیات موجود است. ازآنجاییکه LLMها توان جذب و ترکیب مقادیر عظیمی از اطلاعات را دارند، ممکن است مواجهه پژوهشگران با آثار پیشین را گسترش دهند یا چنانکه برخی گمانهزنی کردهاند، دادههای آموزشی ممکن است آثار پُراستناد را بیش از حد نمایان سازند و در نتیجه LLMها توجه به پژوهشهای بهراحتی قابلکشف را تقویت کنند. ازاینرو پژوهشگران از این پرسش را مطرح کردند که LLMها چگونه کشف ادبیات پیشین را تحتتأثیر قرار میدهند.
برای ارزیابی این فرضیههای رقیب، از مجموعهدادهای استفاده شد که ۲۴۶ میلیون مشاهده و دانلود مقالات arXiv را ثبت میکند که هر یک به شناسه کاربر، شناسه سند arXiv و منبع ارجاع متصل است. این مجموعهداده اجازه داد تغییرات رفتار مطالعه در سطح کاربر پس از انتشار Bing Chat در فوریه ۲۰۲۳ بهعنوان نخستین موتور جستوجوی ادغامشده با LLM که به طور گسترده پذیرفته شد را در مقایسه با GPT-4 بررسی کنند. اسناد arXiv دسترسییافته توسط کاربران Bing پیش و پس از این تغییر برونزا مقایسه شد. برآوردهای مبتنی بر تحلیل اختلاف در اختلاف نشان داد که در مقایسه با دسترسیهای هدایتشده توسط Google، کاربران Bing پس از معرفی Bing Chat مجموعه متنوعتری از اسناد arXiv را کشف کردند. قالبهای انتشار نیز مقایسه شد که نشان داد کاربران Bing با نرخی ۲۶.۳ درصد بالاتر به کتابها دسترسی مییابند که احتمالاً بازتاب توان LLM در برجستهسازی محتوای نهفته در متنهای طولانی است.
افزایش مواجهه با کتابها نشان میدهد که مقاله نوشتهشده به کمک LLM ممکن است به طیف گستردهتری از منابع ارجاعی تکیه کند، اما این امر احتمال تقویت کانونهای کلاسیک علمی را منتفی نمیکند. این احتمال بررسی شد و مشاهده شد که بازدیدهای ارجاعشده از Bing همچنین با پژوهشهای جدیدتر مرتبطاند.
برای بررسی این که آیا این تغییر در نتایج جستوجو به تغییر در رفتار واقعی استناد منجر شده است یا نه، پیشچاپهای arXiv ،bioRxiv و SSRN به دو پایگاه استنادی کلان OpenAlex و Semantic Scholar پیوند داده شد. تعداد ۱۰۱.۶ میلیون استناد به آثار پیشین به دست آمد و سپس با روش مطالعه رویدادی رفتار استنادی نویسندگان پیش و پس از پذیرش LLM نسبت به گروه کنترل بررسی شد سه ویژگی مراجع استنادی شامل قالب انتشار (استناد به کتابها)، وقفه زمانی (سن میانه مرجع) و اثرگذاری اثرِ استنادشده (میانگین لگاریتم استنادهای اسناد مرجع) بررسی شد. یافتهها نشان میدهند استفاده از LLM رفتار استنادی نویسندگان را تغییر میدهد و ظاهراً آنها را بهسوی پایگاه دانشی متنوعتر هدایت میکند. در مجموع ۱۱.۹ درصد بیشتر به کتابها استناد کردند، هرچند این اثر SSRN از نظر آماری معنادار نیست.
شواهدی سافت شد که نشان میدهد هوش مصنوعی پژوهشگران را به بدنه دانشی گستردهتری هدایت میکند. پژوهشگران با محدودیتهای زمان و توجه مواجهاند که توان آنها برای پردازش جهانِ روبه گسترش پژوهش را محدود میکند. به نظر میرسد LLMها به پژوهشگران کمک میکنند بر موانع کشف ادبیات مرتبط فائق آیند.
این یافتهها نشان میدهد که اگرچه LLMها ممکن است نشانههای تلاش مؤلف را مبهم کنند، اما مسیر کشف دانش را گسترش میدهند. نگرانی رایج این بوده است که جستوجوی مبتنی بر هوش مصنوعی کانونهای علمی موجود را تقویت کند؛ اما پذیرش LLM اثر معکوس داشته است. هم رفتار جستوجوی مبتنی بر هوش مصنوعی و هم الگوهای استناد نویسندگان، چرخشی معنادار بهسوی پایگاه دانشی متنوعتر را نشان میدهند؛ پایگاهی که شامل کتابهای بیشتر و نیز آثار جدیدتر و کماستنادتر است. این گسترش توجه نشان میدهد LLMها به پژوهشگران کمک میکنند محدودیتهای شناختیای را که توان تعامل آنها با جهانِ همواره در حال گسترش ادبیات علمی را محدود کرده بود، پشت سر بگذارند.
محدودیتها و مسیرهای آینده
در این مطالعه، اثرات LLMها بر تولید علمی را بررسی شد، اما یافتههای آن با چندین محدودیت همراه است. نخست، تفسیر اثرات برآوردشده بهعنوان علّی مستلزم مفروضاتی است که باتوجهبه محدودیتهای دادهای ذاتیِ مطالعه LLMها در میدان عمل بهسختی برآورده میشوند. روش تشخیص هوش مصنوعی موردبررسی کامل نیست و در معرض چالشهای متعددی قرار دارد. این روش به چکیدهها تکیه دارد نه متن کامل و نمیتواند به طور قطعی مشخص کند کدام نویسنده در یک تیم از LLM استفاده کرده است و تقریباً قطعاً در تشخیص استفاده توسط نویسندگانی که متن LLM را بهشدت ویرایش میکنند ناکام میماند. افزون بر این، پذیرش غیرتصادفی ابزارهای هوش مصنوعی امکان سوگیری خودگزینی را ایجاد میکند و تمرکز بر پیشچاپهای ارسالشده بدان معناست که «زمان پذیرش» ممکن است نسبت به بهرهوری درونزا باشد.
دوم، یافتهها تصویری لحظهای از فناوریای که بهسرعت در حال تحول است ارائه میکنند. این تحلیل بر دادههایی متکی است که پیش از ورود مدلهای استدلالی پیشرفتهتر و قابلیتهای پژوهش عمیق تولید شدهاند. با بهبود مدلها و کشف شیوههای جدید ادغام آنها در کار علمی، اثرات آینده این فناوریها احتمالاً بسیار فراتر از اثراتی خواهد بود که در اینجا برجسته شده است. این امر جهتگیری حیاتی برای پژوهش آینده را پیش میکشد؛ یعنی پایش مستمر چگونگی ادغام نسلهای پیدرپی مدلهای هوش مصنوعی در بنگاه علم.
یافتهها نشان میدهد LLMها شروع بازطراحی تولید علم کردهاند. این تغییرات از چشماندازی پژوهشی حکایت دارند که در آن ارزش تسلط به زبان انگلیسی کاهش مییابد، اما اهمیت چارچوبهای ارزیابی کیفیتِ مستحکم و موشکافی عمیق روششناختی به اوج میرسد. برای داوران همتا، سردبیران مجلات و جامعهای که بهطورکلی این آثار را تولید، مصرف و به کار میگیرد، مسئلهای بزرگ است. بهعنوان میانبُری برای غربال (ناقص) پژوهش علمی، ویژگیهای نگارشی بهسرعت به سیگنالهایی غیرآگاهیبخش تبدیل میشوند؛ آن هم درست در زمانی که کمیت ارتباطات علمی جهش میکند. با کماثرشدن میانبُرهای سنتی، سردبیران و داوران ممکن است بیشازپیش به نشانگرهای منزلتی مانند پیشینه نویسنده و وابستگی نهادی بهعنوان سیگنال کیفیت تکیه کنند که اثرات دموکراتیزهکننده LLMها بر تولید علم را خنثی میکند. یک راهحل بالقوه، بهرهگیری از همان فناوری برای یاری در ارزیابی دستنوشتههاست. «عاملهای داور» تخصصی میتوانند ناسازگاریهای روششناختی را پرچمگذاری کنند، ادعاها را راستیآزمایی کنند و حتی نوآوری را بسنجند. اینکه آیا چنین رویکرد مقیاسپذیری به سردبیران و داوران کمک خواهد کرد بهجای نشانههای سطحی بر محتوا تمرکز کنند یا چالشهای جدید و پیشبینینشدهای را به فرایند علمی وارد خواهد کرد، عدم قطعیتی حیاتی است.